

 リターンマッチ
- ニュース
編集可能で、画像の修正がとても簡単に!SenseNova U1 インフォグラフィック強化版V3をリリース
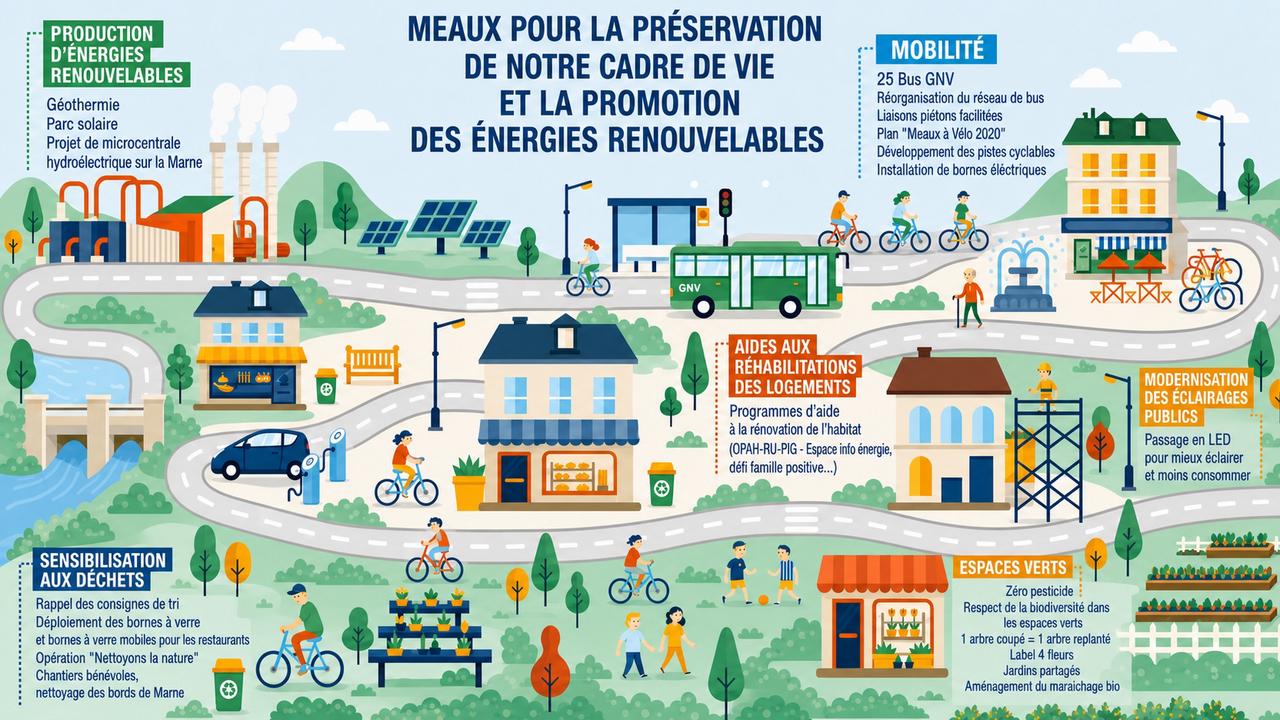
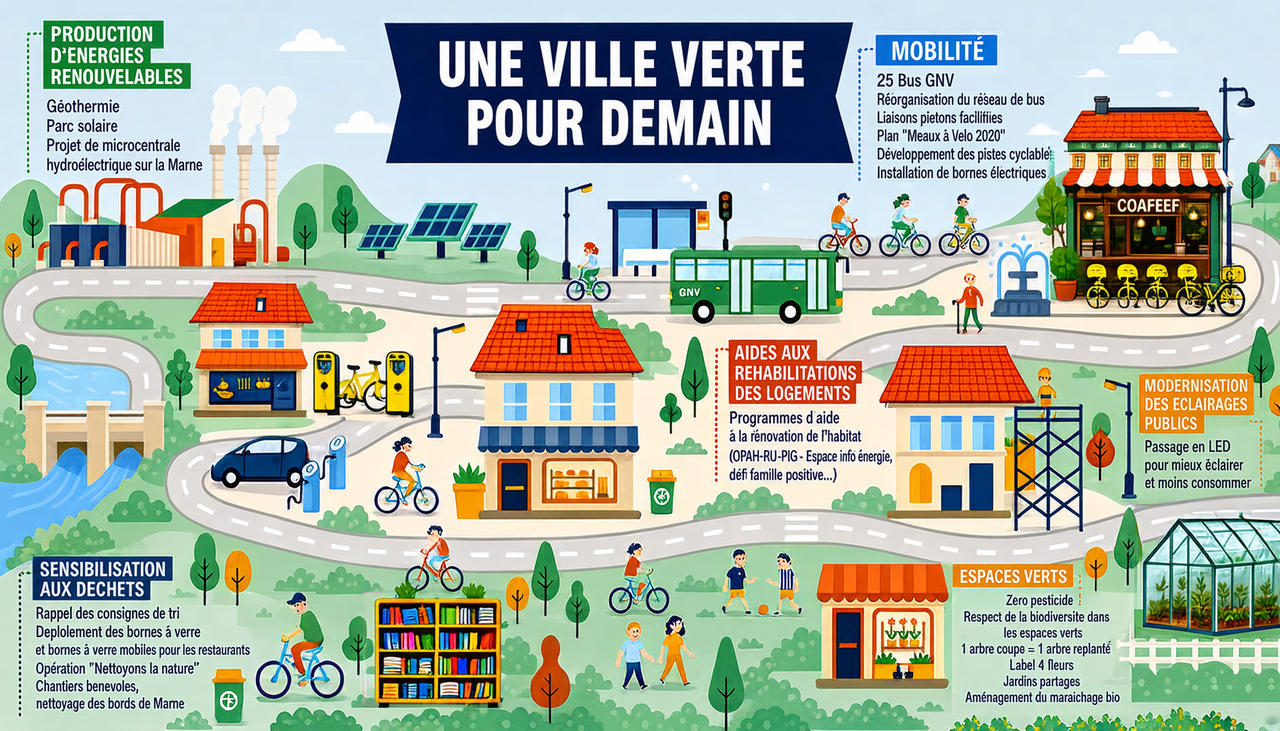
「間違い探し」ゲームに挑戦してみましょう。左から右へ、合計何箇所が編集されたか分かりますか?
左が元の画像、右が編集後の画像です。(※本文内の画像はクリックで拡大表示できます)
画像生成技術が実用化フェーズに移行するにつれ、画像生成モデルのレイアウトおよびテキスト生成能力は急速に向上しています。より豊富なレイアウト、より明確な階層構造、そしてより自然なテキストと画像の融合により、AIが生成するインフォグラフィックは実際の制作ニーズに大きく近づいています。
しかし、情報密度が高い領域においては、誤字修正、アイコンの調整、コンテンツの追加といった部分的な修正を完全に避けることは困難です。たった1つの文字の誤りであっても、画像全体が使えなくなってしまうことがあり、ユーザーは再生成を繰り返す(ガチャを引く)しかありませんでした。
テキストと画像の融合および構造化されたビジュアルコンテンツ生成におけるモデルの実用・提供能力をさらに向上させるため、SenseTimeは「SenseNova U1 インフォグラフィック強化版V3」(SenseNova-U1-8B-MoT-Infographic-V3、以下「Infographic-V3」)をリリースしました。
モデルウェイトのダウンロードURL:
https://huggingface.co/sensenova/SenseNova-U1-8B-MoT-Infographic-V3
新バージョンは、V2の強力なインフォグラフィック生成能力を継承しつつ、初めて「インフォグラフィック編集機能」を追加しました。全体的なデザインに満足している場合、最初から作り直す必要はなく、部分的なテキストや全体的なスタイルのみを修正して作品をブラッシュアップし続けることができます。
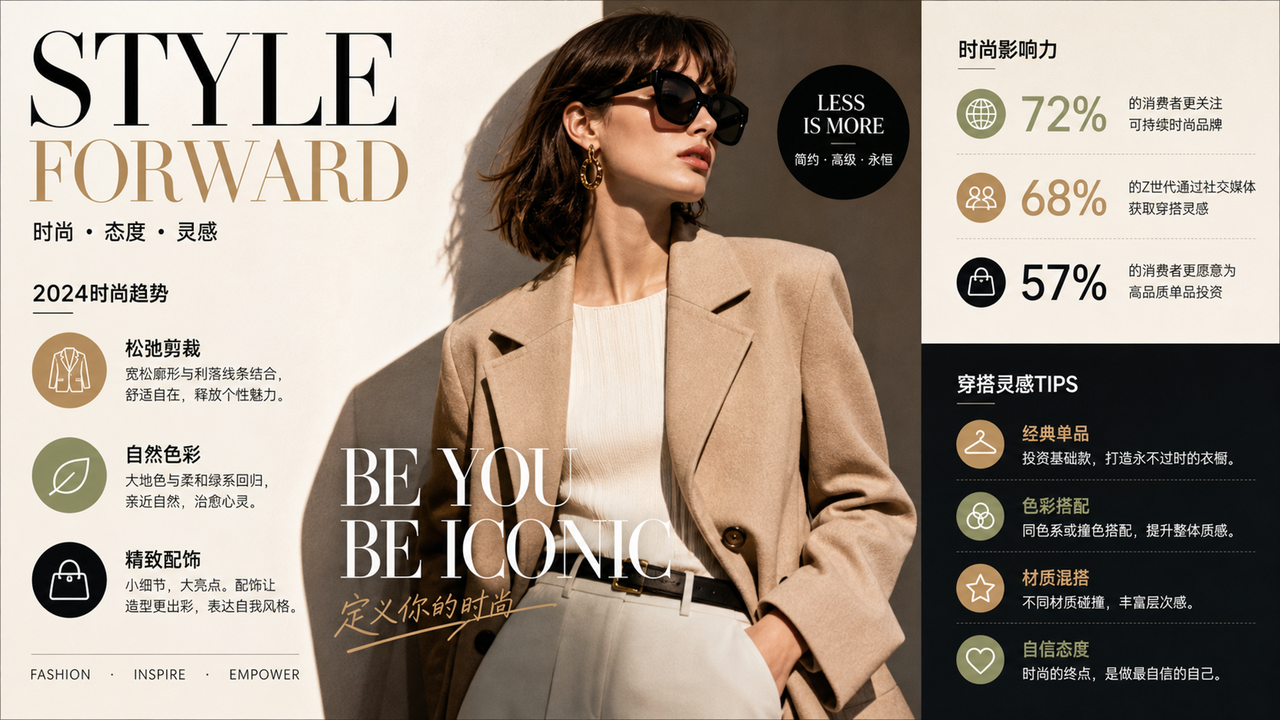
元画像
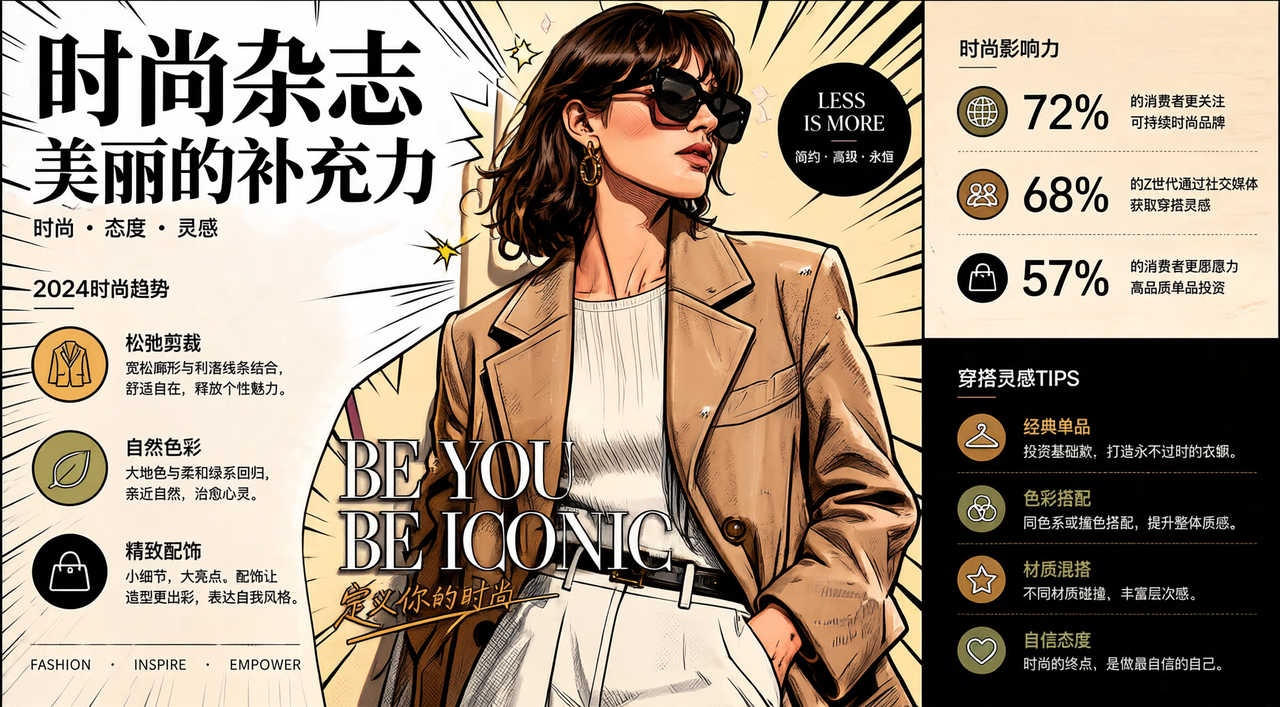
スタイルをコミック風に変更し、以下の修正を行います。第1の修正:元画像のテキスト「STYLE」を「ファッション誌」に置換。第2の修正:元画像のテキスト「FORWARD」を「美しさの補給力」に置換。
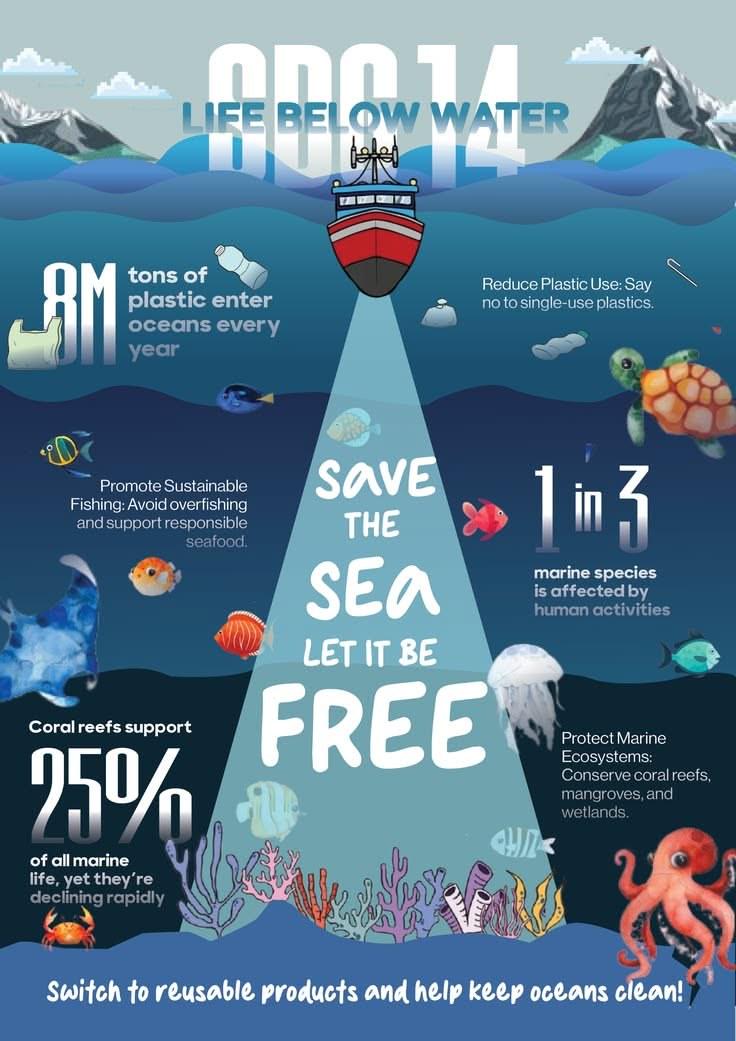
元画像
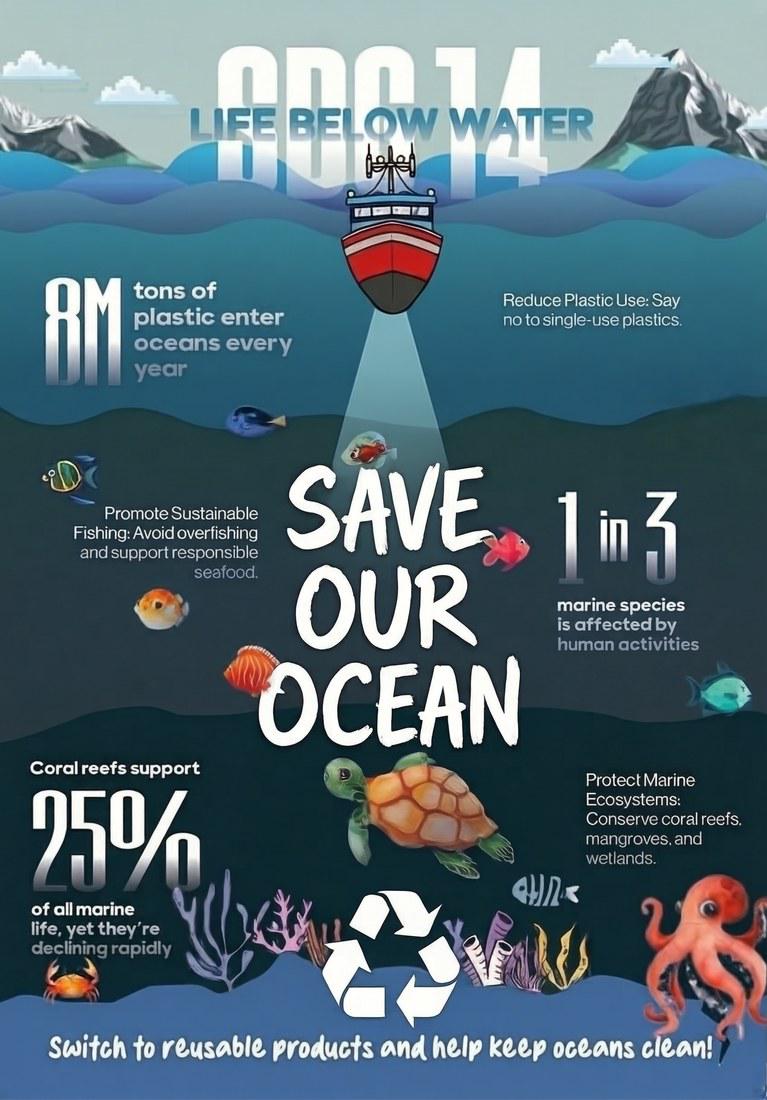
海面下のレジ袋、ペットボトル、ストローを削除し、中央のスローガンを白色の手書き風で「SAVE OUR OCEAN」に変更。右側のウミガメをテキストの下に移動し、下部にリサイクルマークを追加。海の層状構造の明瞭さを維持。
「再生成」から「必要に応じた修正」へ:わずかなエラーで良作を無駄にしない
Infographic-V3は多様なインフォグラフィック編集方式に対応しています。ユーザーは画像上の対象領域を指定してピンポイントで修正することも、自然言語(プロンプト)で修正内容を直接指定することも可能です。誤字、脱字、重複テキストに対しても、モデルは元のレイアウト、イラスト、ビジュアル構造を極力維持したまま修正を実行します。
対象領域を指定したピンポイント修正
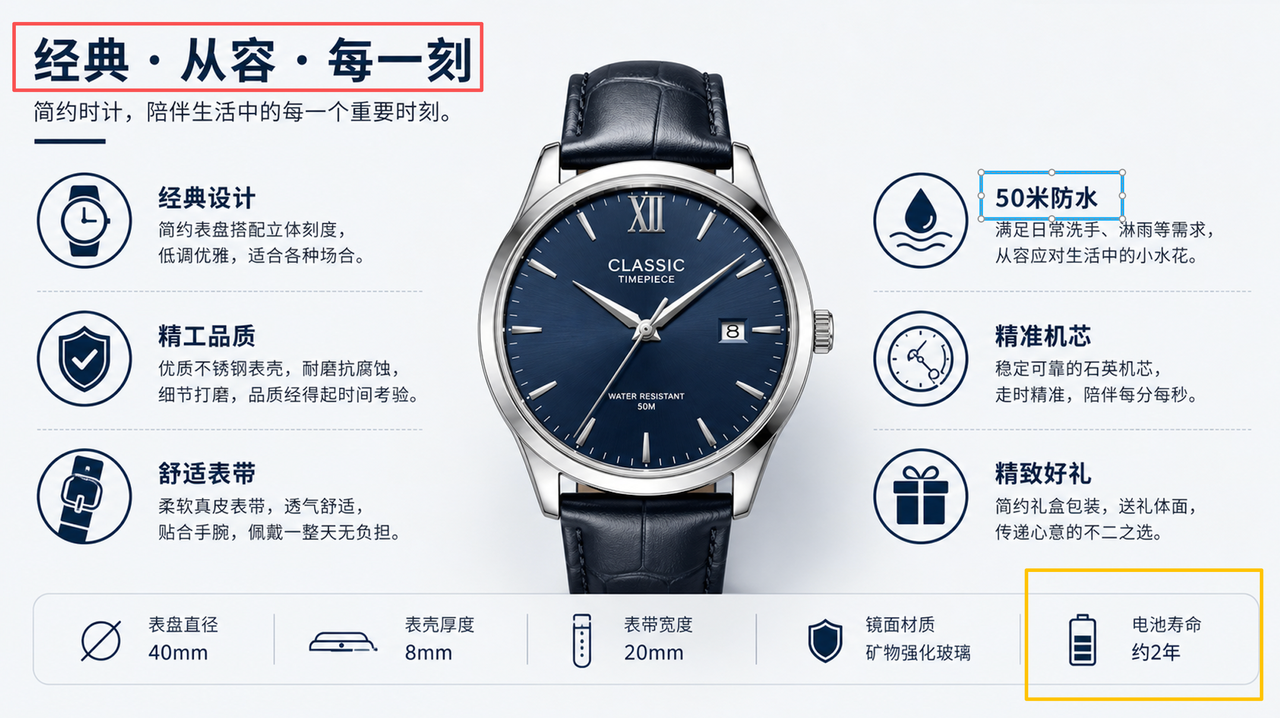
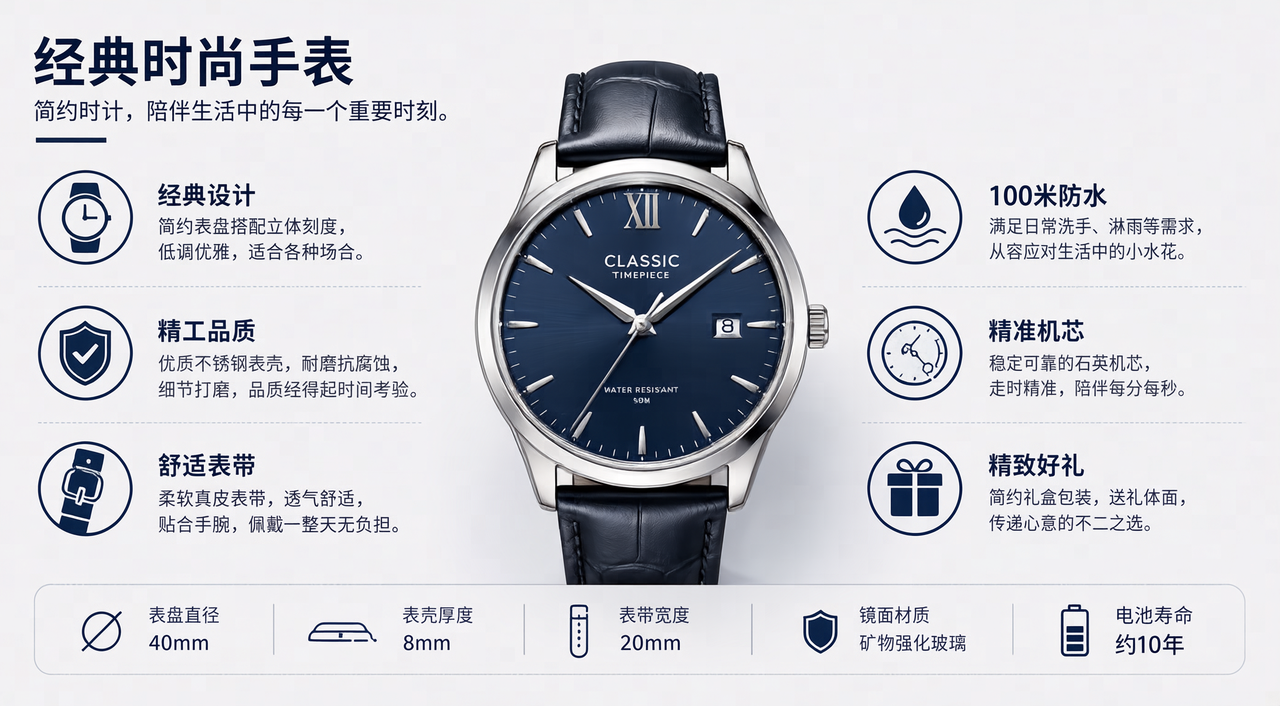
赤枠の「クラシック・ゆとり・いつの瞬間も」を定番のファッションウォッチに変更、青枠を「100m防水」に変更、オレンジ枠を「バッテリー寿命約10年」に変更
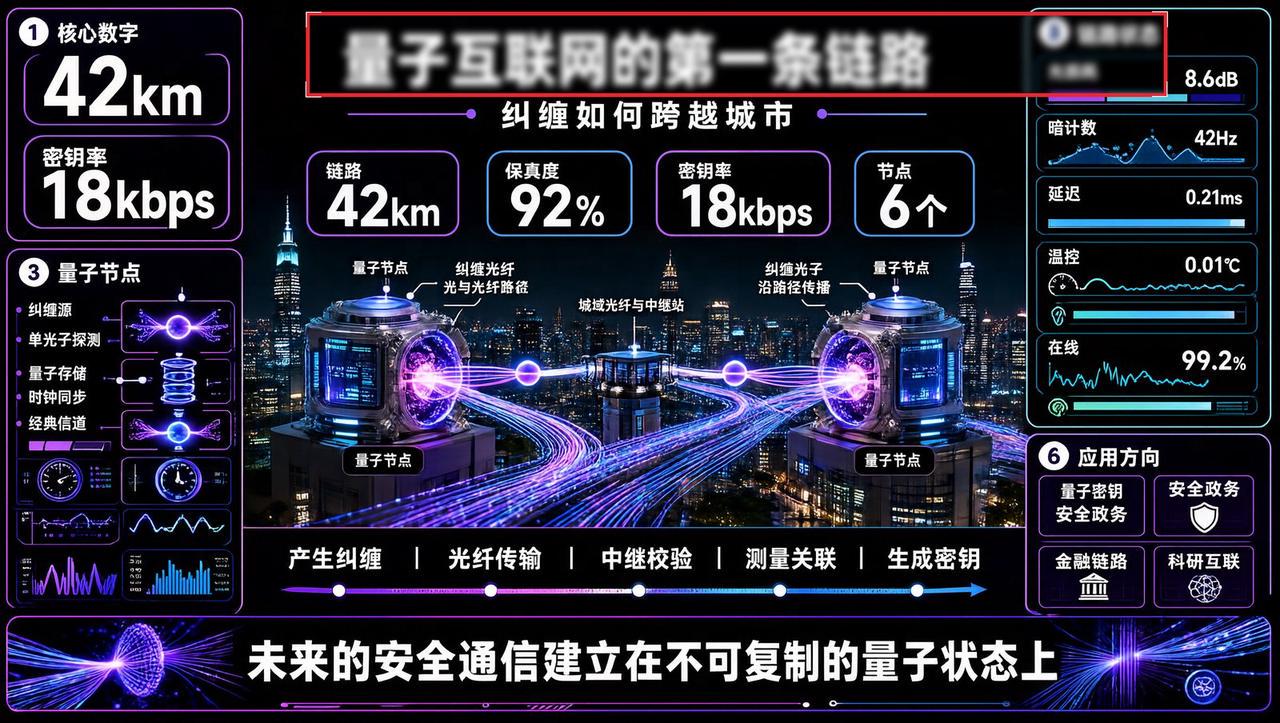
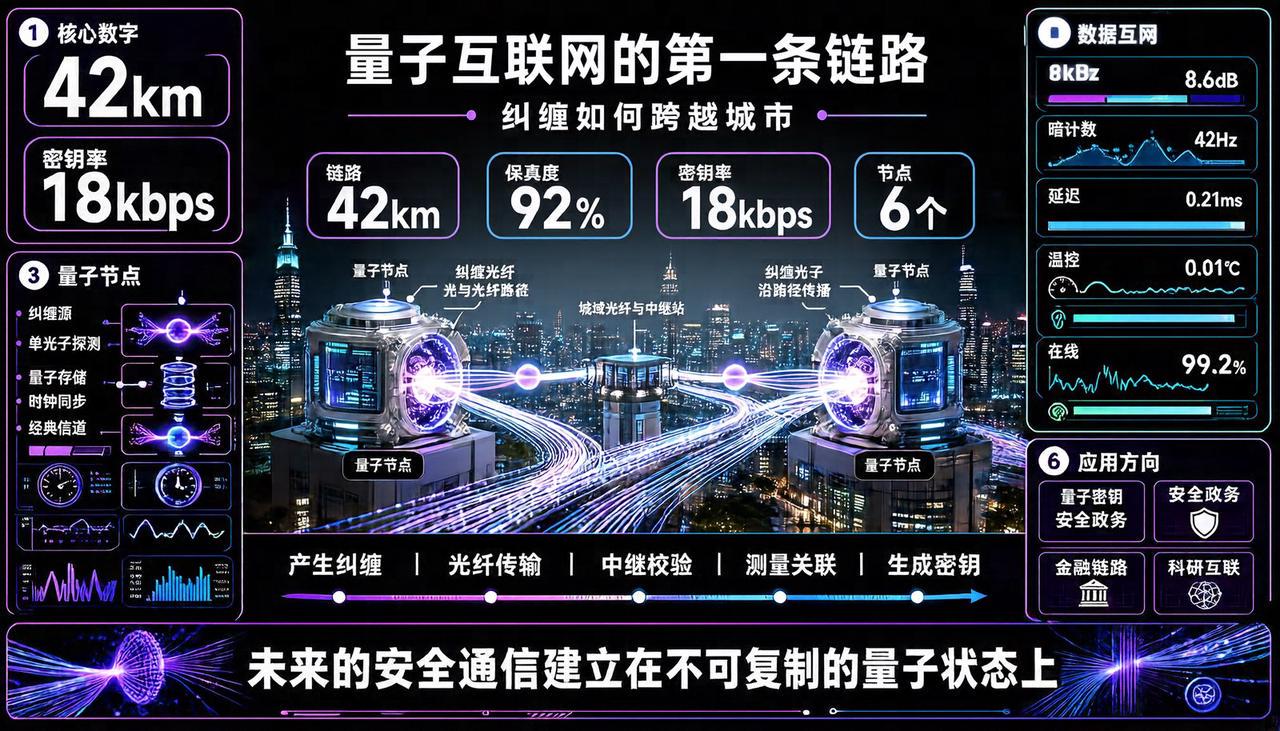
赤枠内の不鮮明なタイトルを「量子インターネットの最初のリンク」に修復し、その他は変更なし
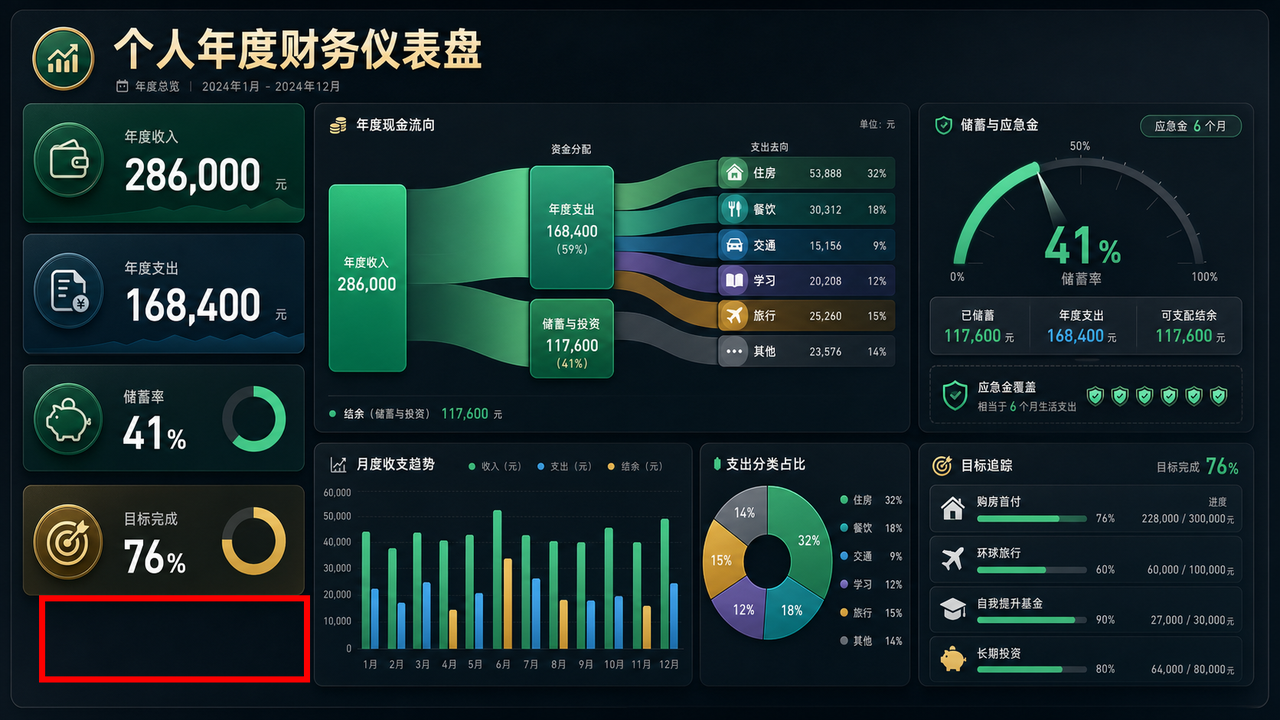
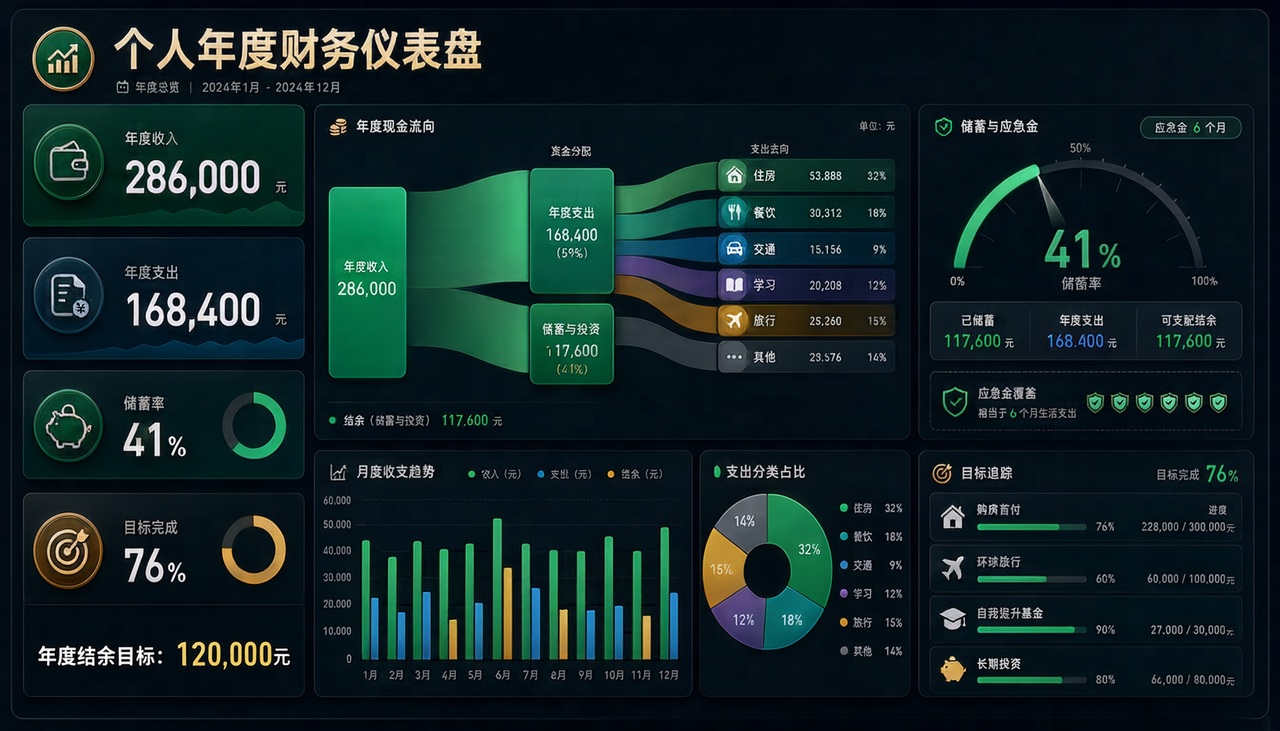
赤枠内に「年間繰越目標:120,000元」を追加
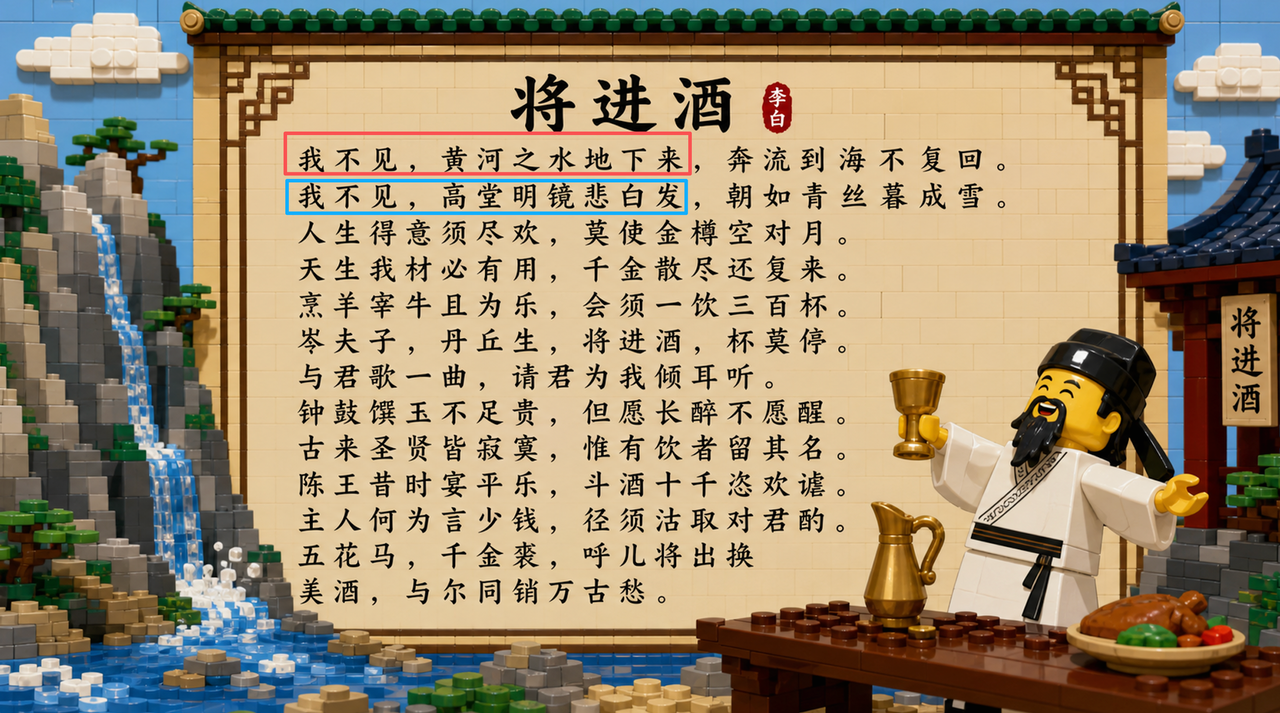
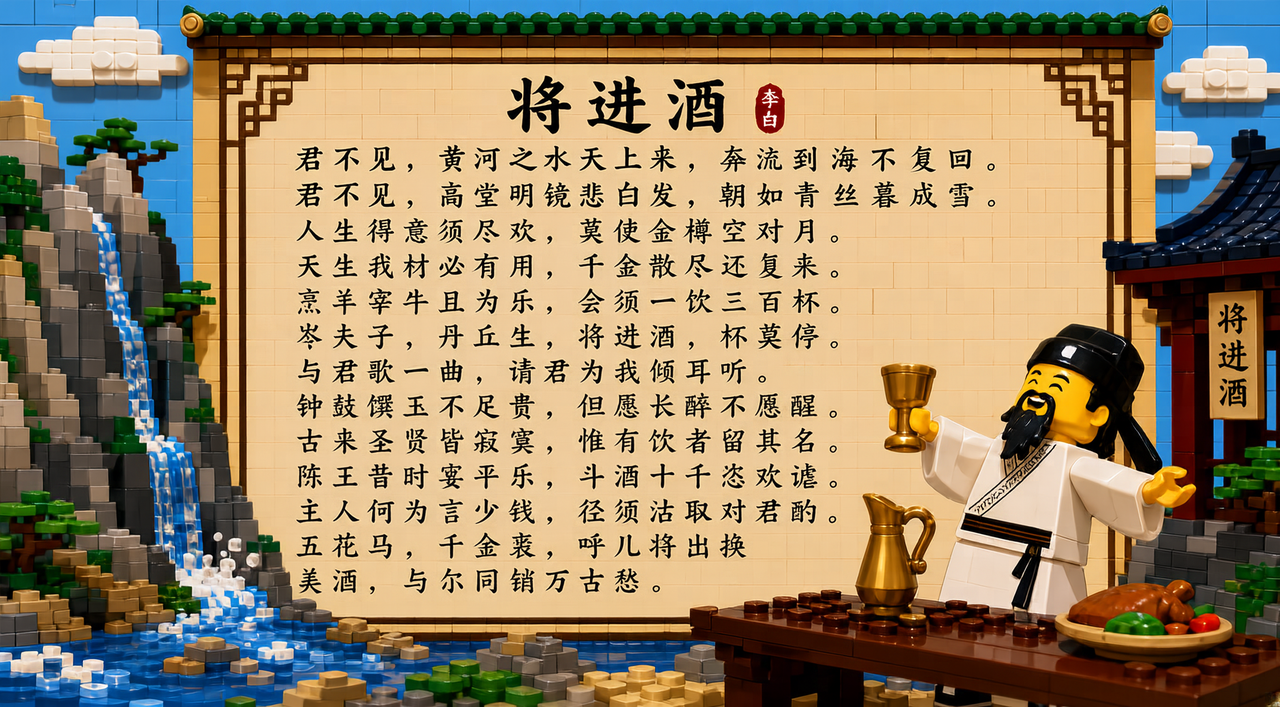
赤枠の「我不見、黄河之水地下来」を「君不見、黄河之水天上来」に置換。青枠の「我不見、高堂明鏡悲白発」を「君不見、高堂明鏡悲白発」に置換
自然言語プロンプトによる直接指定修正
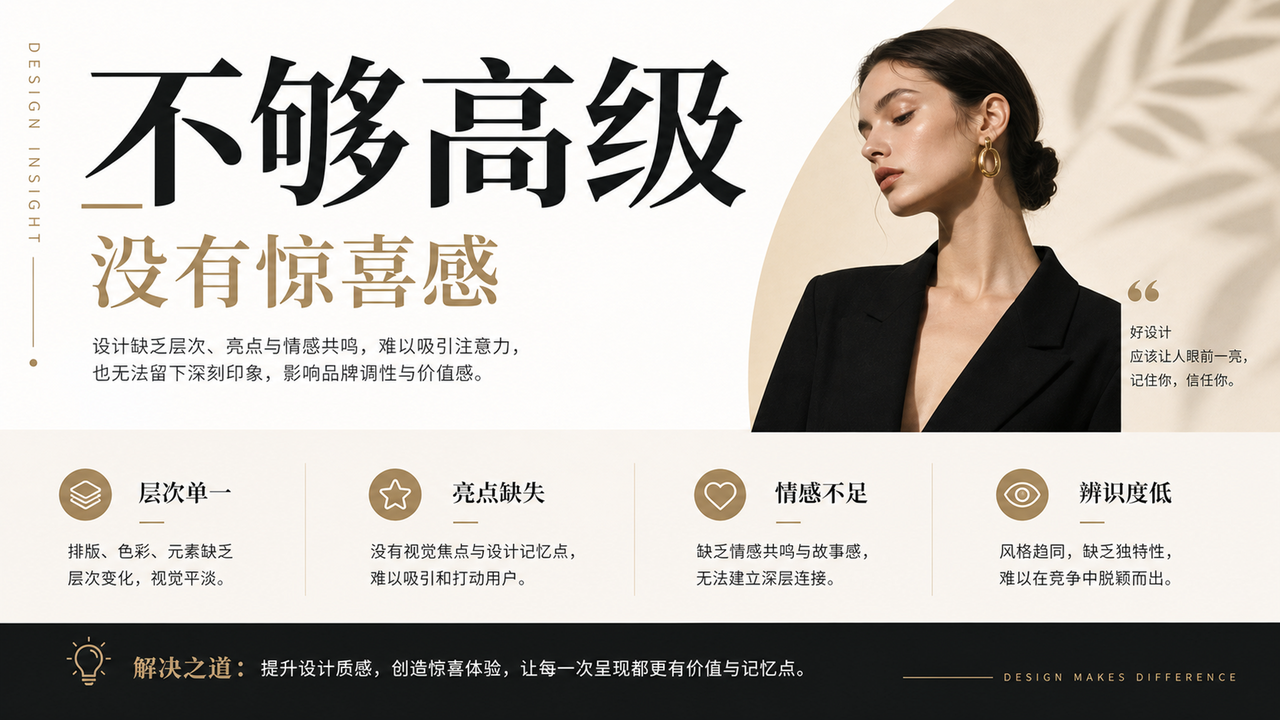
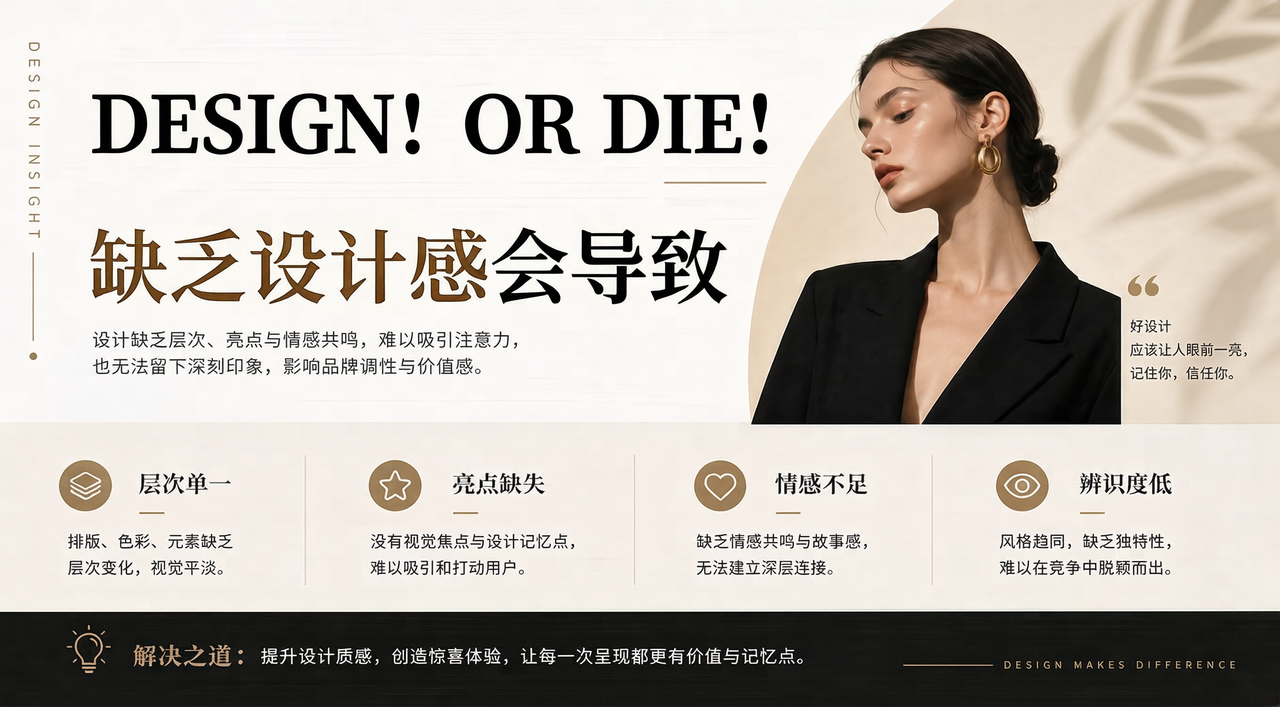
第1の修正:元画像のテキスト「高級感が足りない」を「DESIGN!OR DIE!」に置換。第2の修正:元画像のテキスト「驚きがない」を「デザイン性の欠如が招くもの」に置換
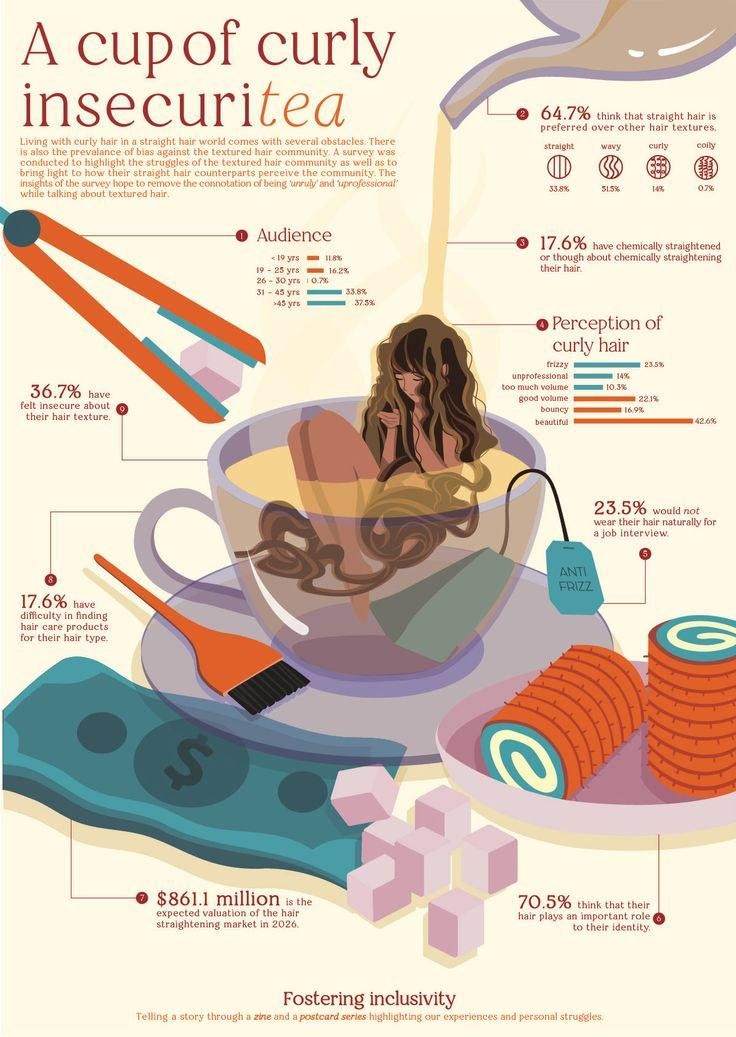
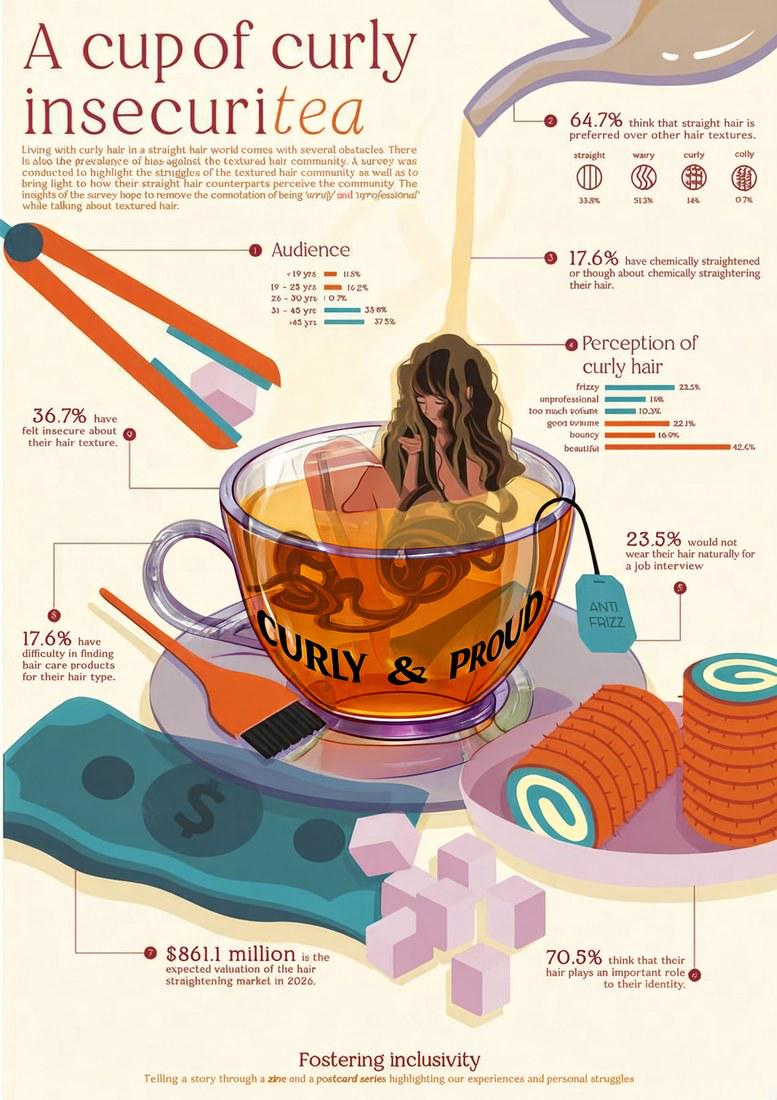
透明なカップの表面に「CURLY & PROUD」を追加。文字はカップの曲面に沿って自然に変形させ、ガラスや茶葉を通した透明感と色収差を表現
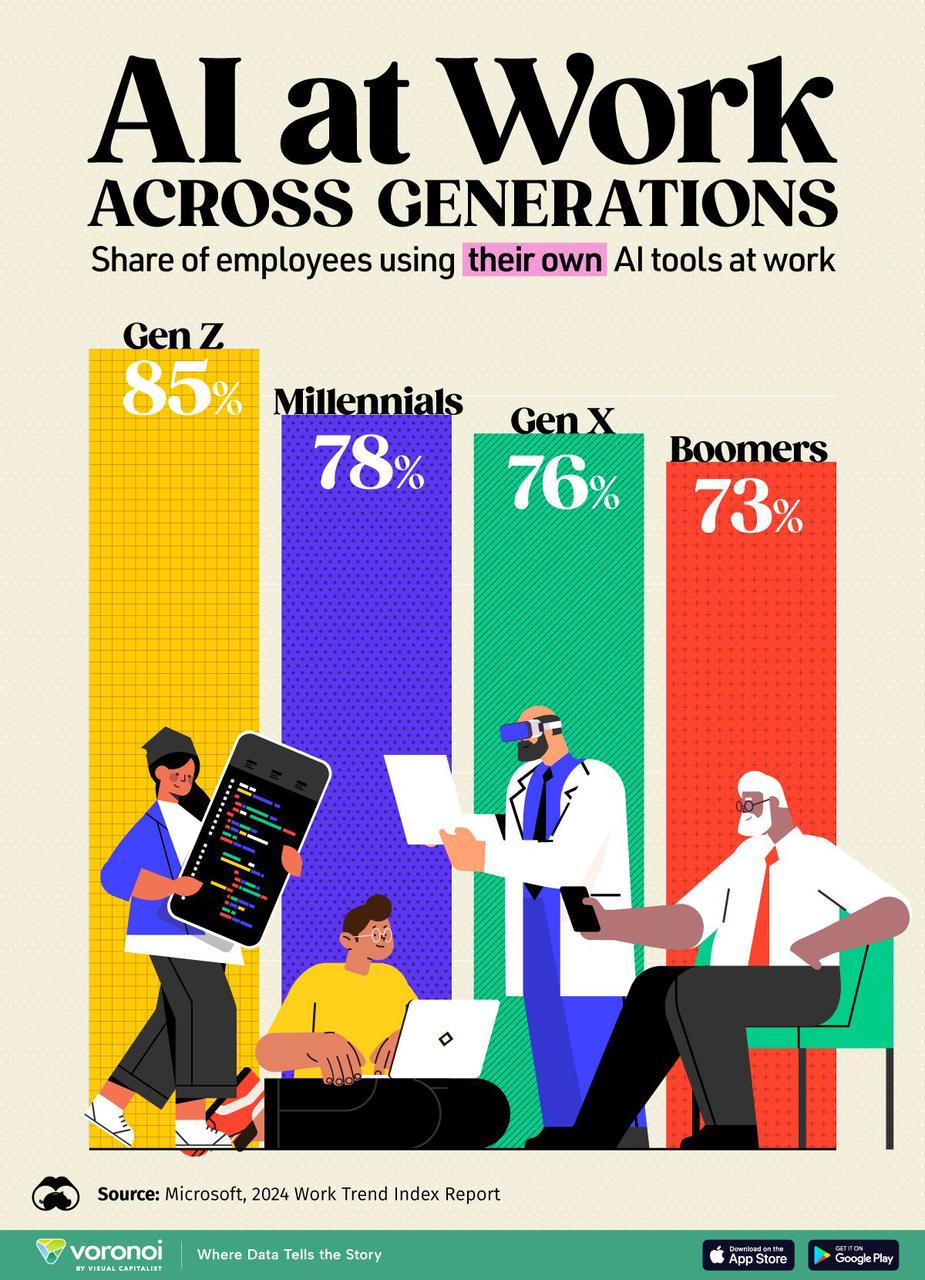
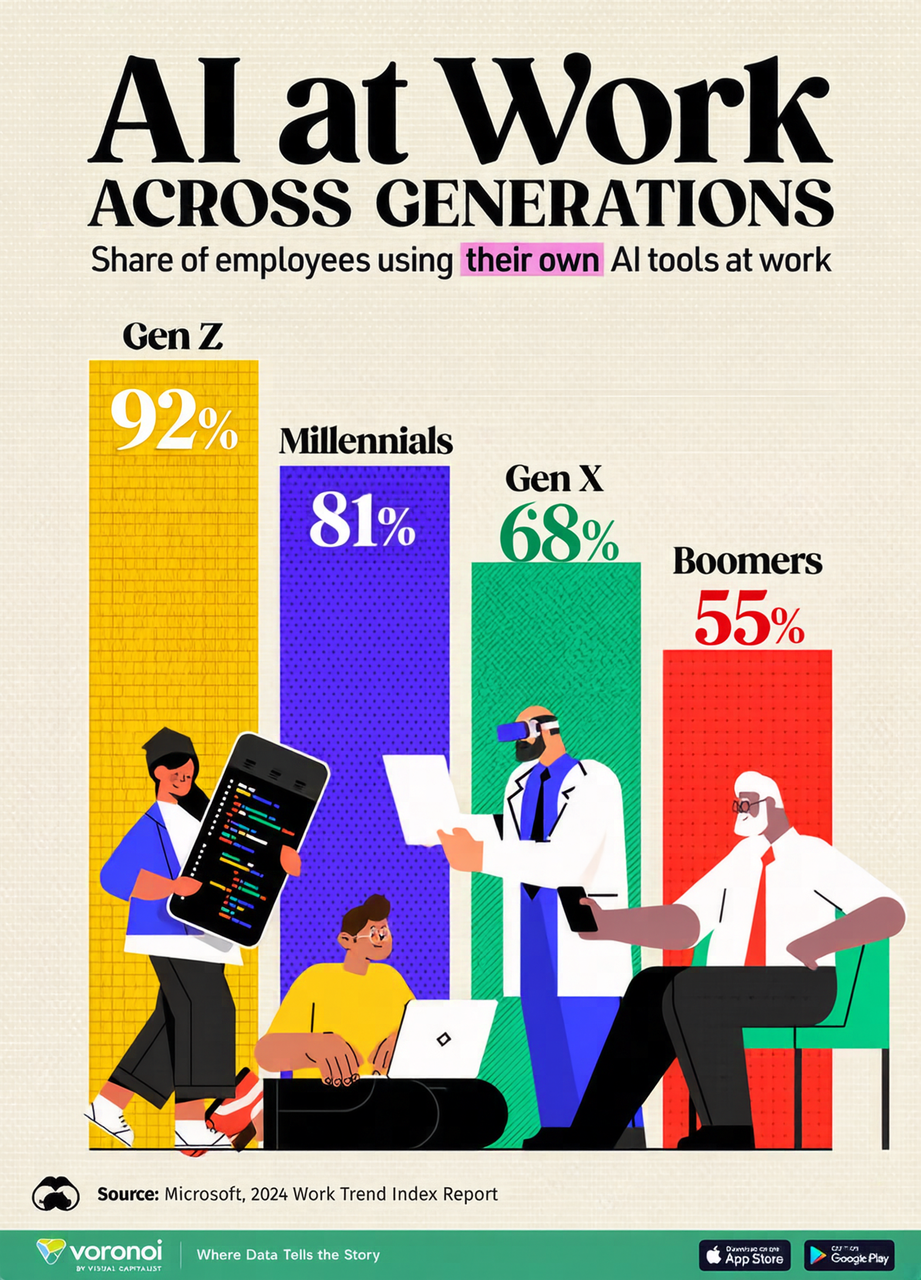
4世代の従業員における個人AIツール利用率を順に「Gen Z 92%」「Millennials 81%」「Gen X 68%」「Boomers 55%」に変更し、4本のカラー棒グラフの高さを連動して調整。人物イラスト、英語タイトル、配色テクスチャ、出典、ブランド情報は変更なし
部分的なコンテンツ編集
テキストの修正だけでなく、部分的なコンテンツに満足がいかない場合などにも編集が可能です。
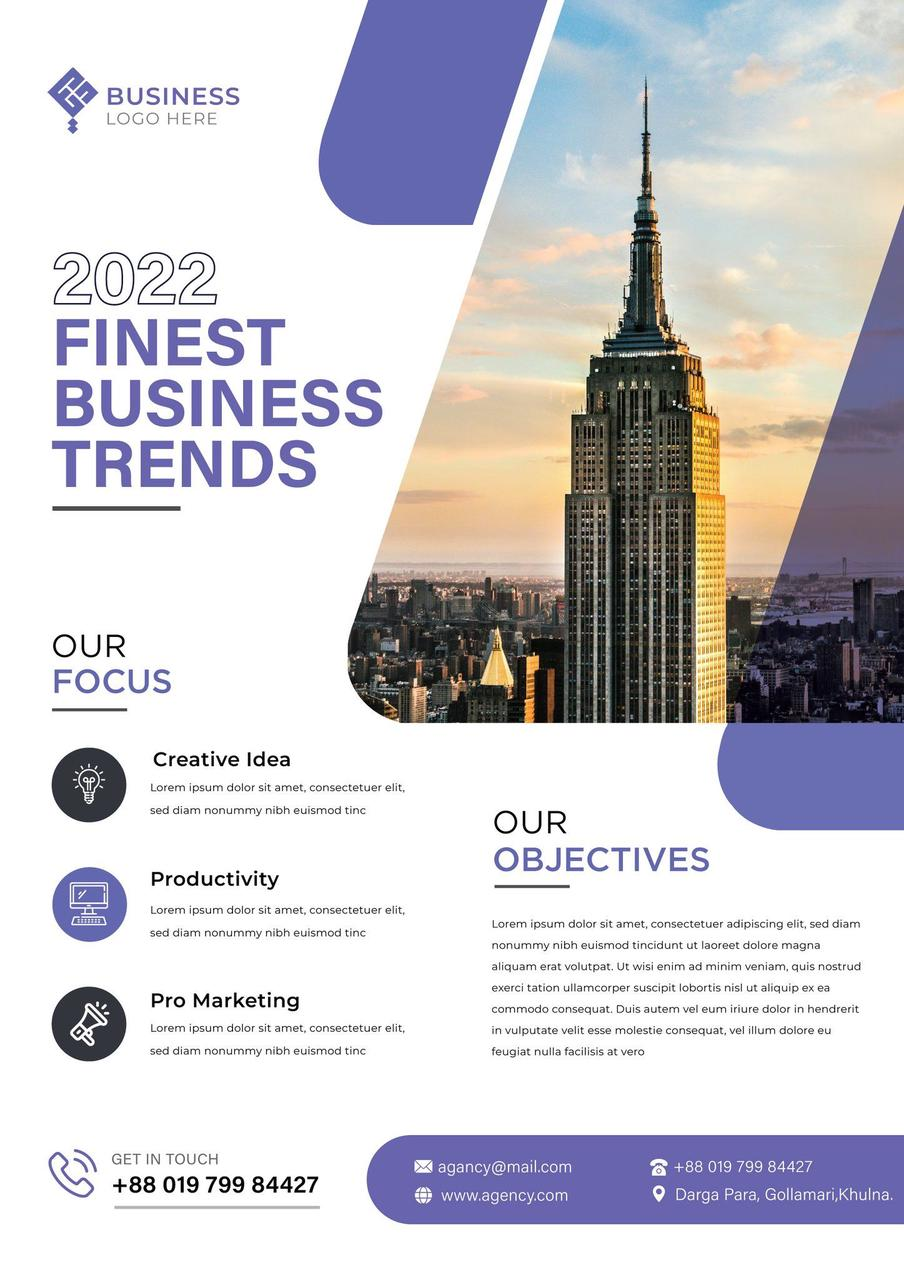
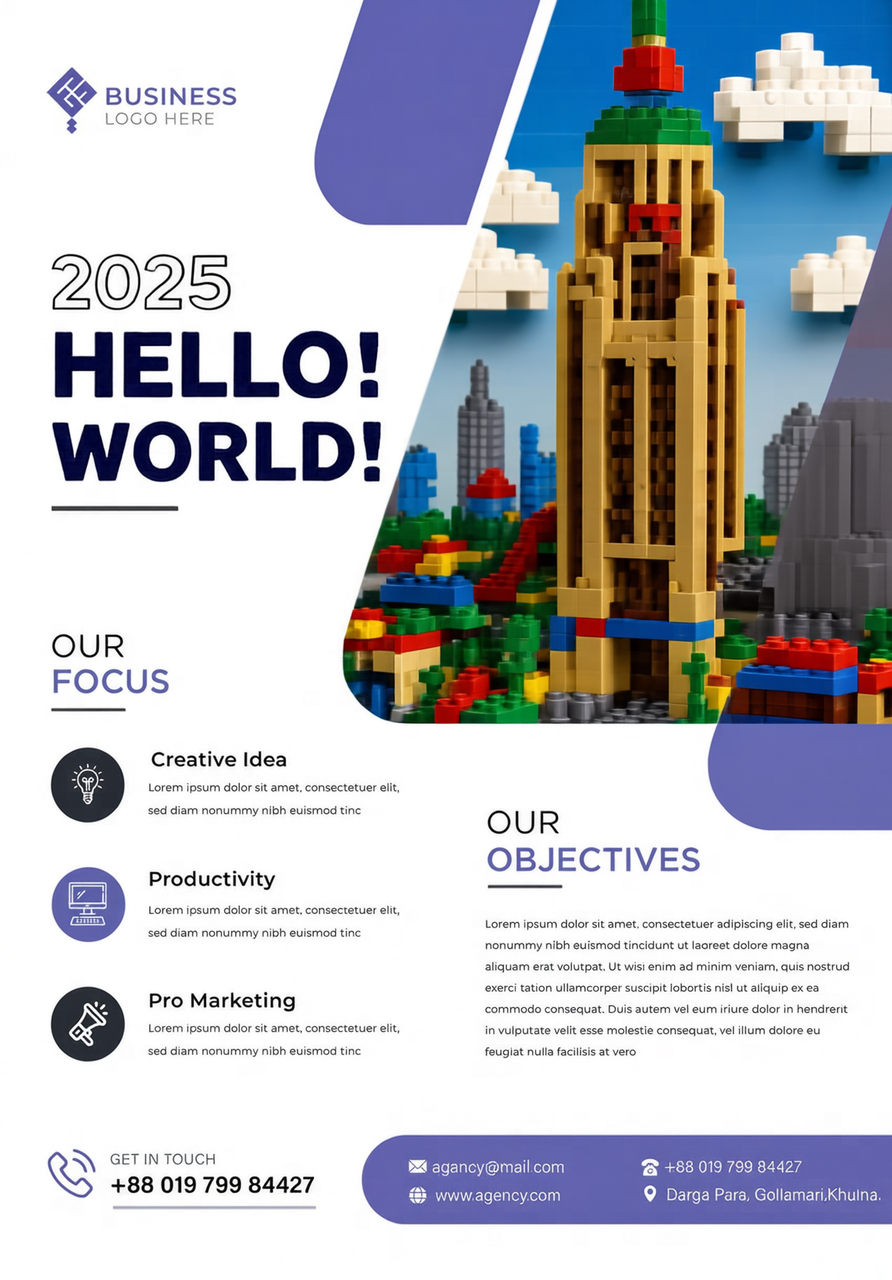
メインテーマをレゴスタイルに変更。元画像のテキスト「2022」を「2025」に置換。第2の修正:元画像のテキスト「FINESTBUSINESSTRENDS」を「HELLO! WORLD!」に変更
全体的なスタイル編集
部分修正に加え、Infographic-V3はインフォグラフィック全体のスタイル調整にも対応しています。コアとなる情報や構造を維持したままビジュアル表現を変更できるため、1つのコンテンツを異なるブランド、テーマ、配信シナリオに最適化できます。
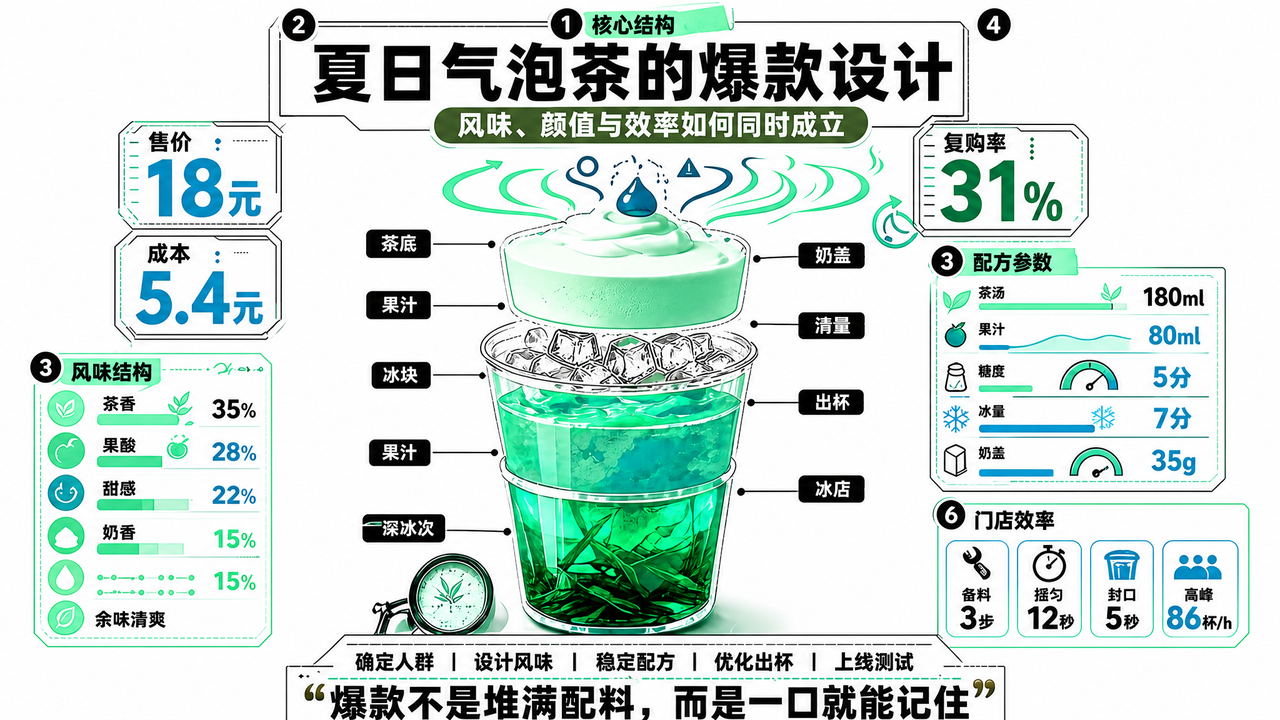
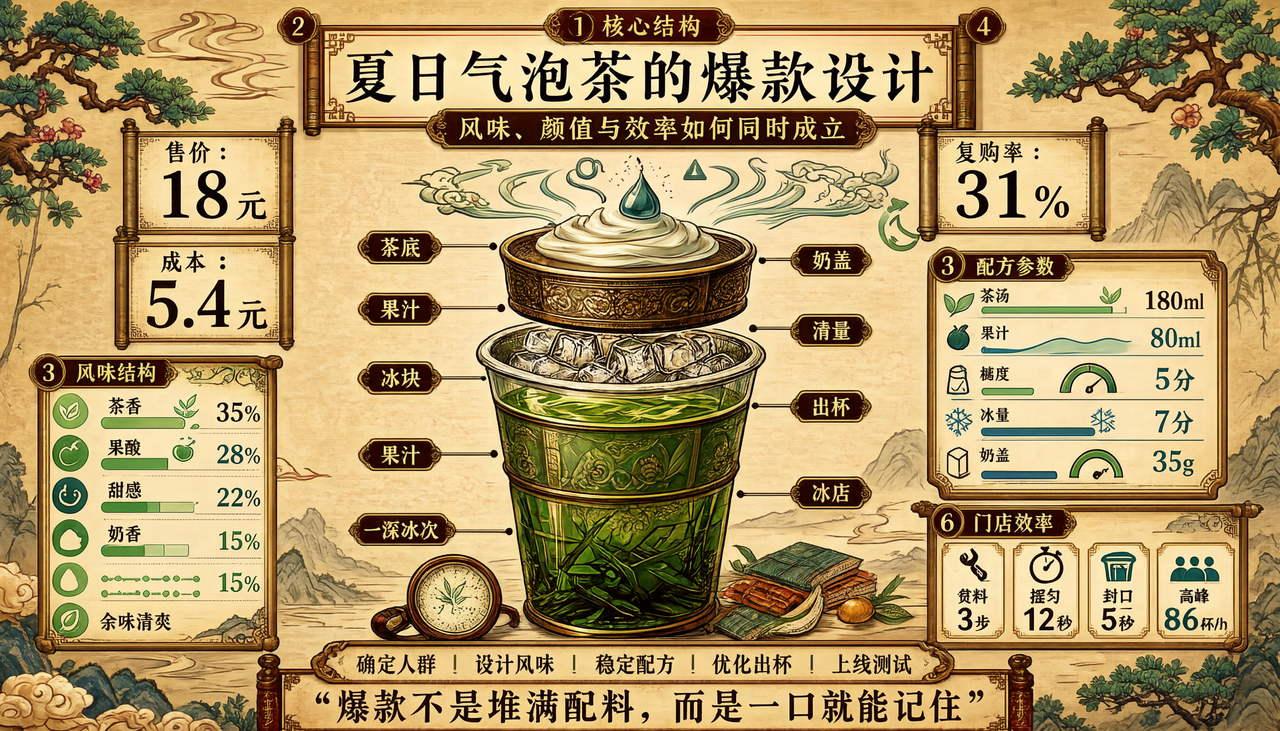
画像スタイルを中国伝統スタイルに変更し、フォントを明朝体に変更
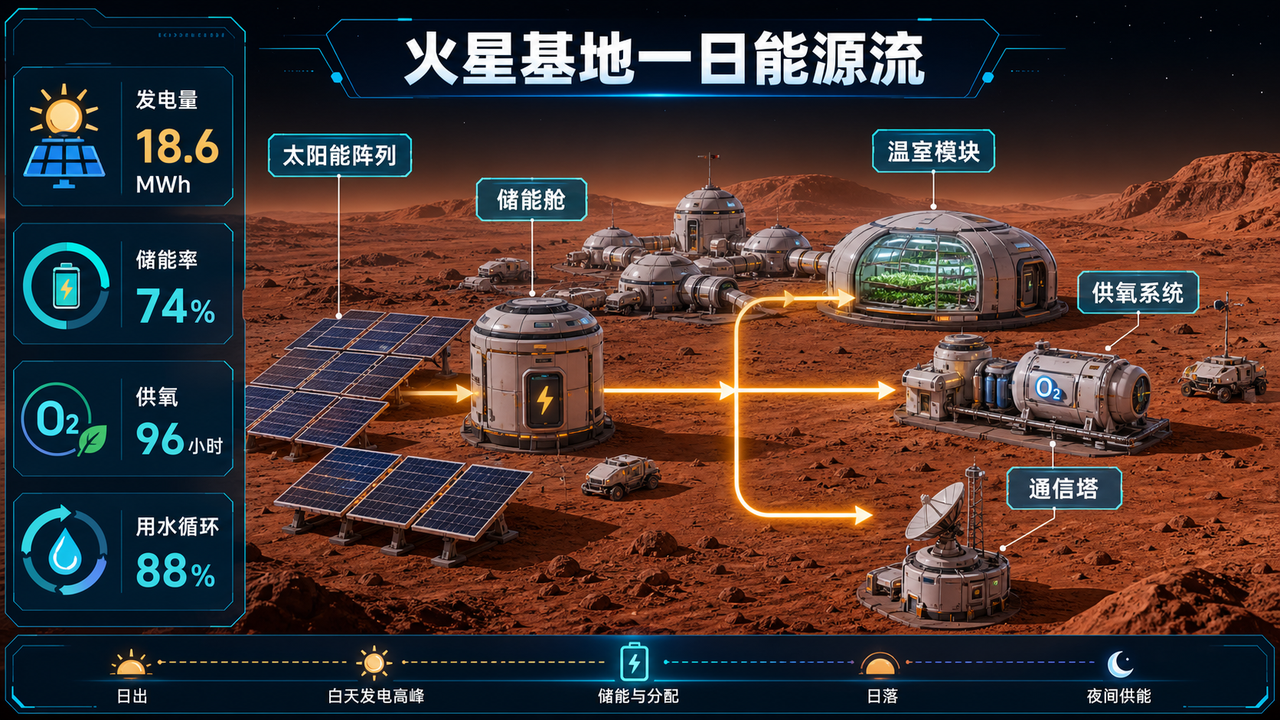
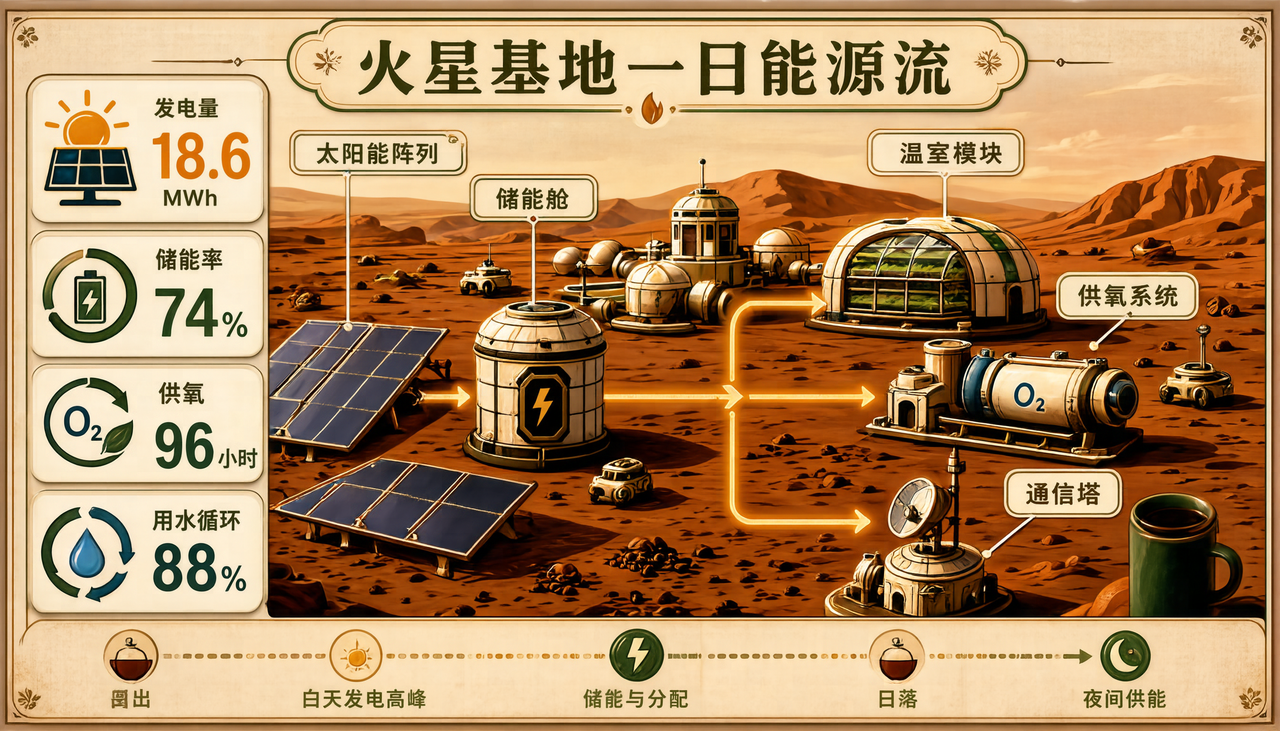
内容はそのまま維持し、明るいトーンのスタイルへ変更
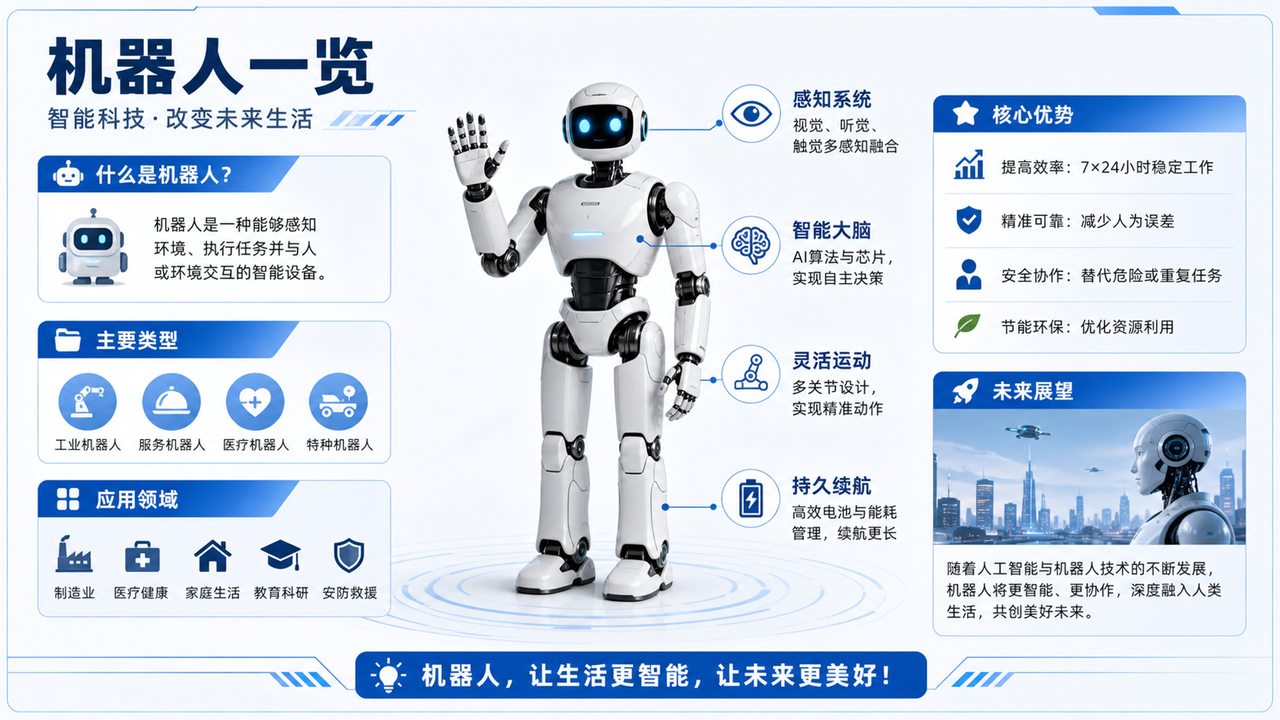
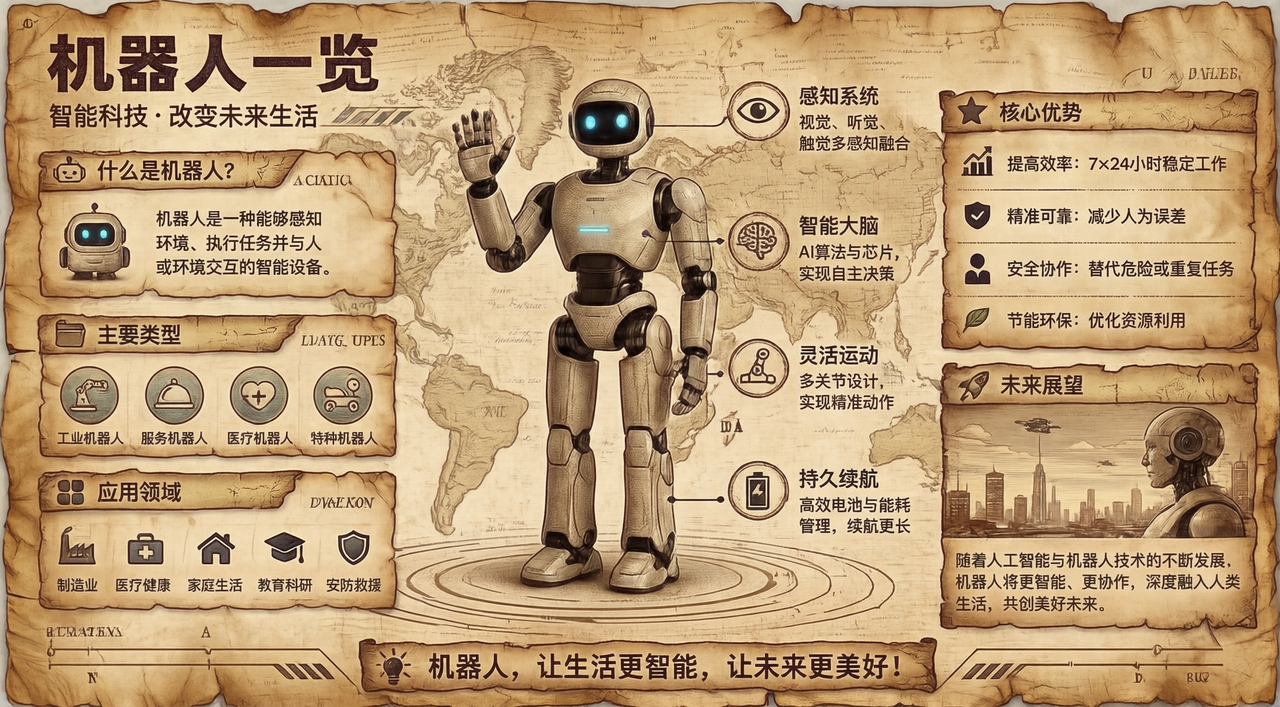
スタイルをレトロな羊皮紙地図風に変更。すべてのテキスト、データ、レイアウトは保持
全体的なレイアウト編集
さらに、Infographic-V3は全体的なレイアウト編集能力を備えており、コア情報を維持した上でコンテンツの階層やレイアウト構造を再構築できます。これにより情報の提示がより明瞭になり、様々なサイズや利用シーンに柔軟に対応できます。
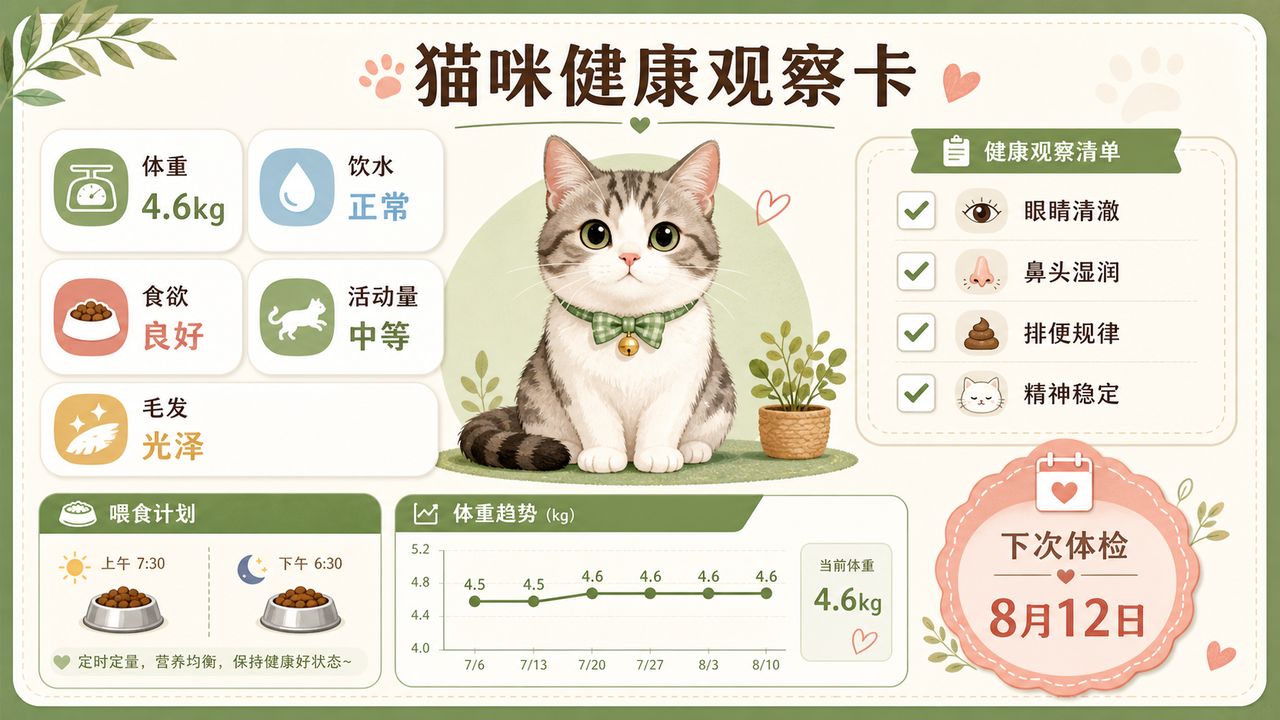
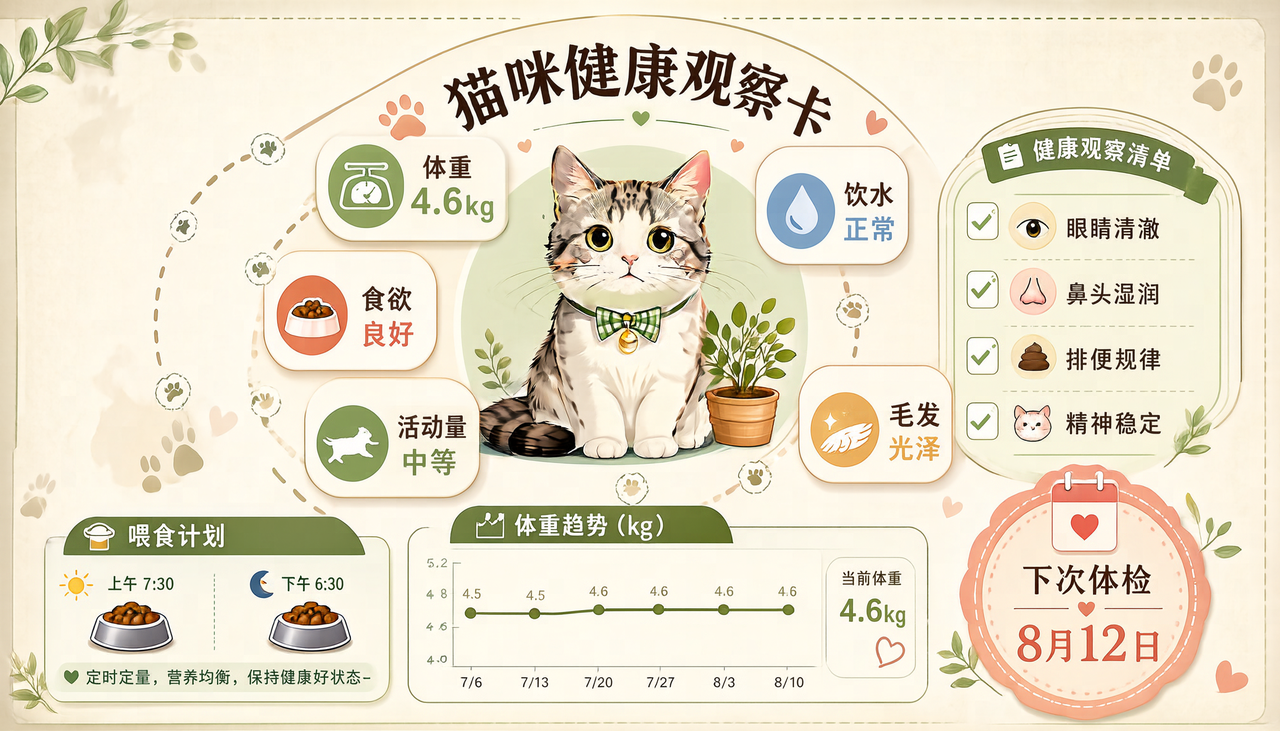
情報はほぼそのまま維持し、レイアウトを美しく刷新
インフォグラフィック生成能力
最も重要な点として、編集機能の追加によって生成能力が損なわれることはありません。Infographic-V3は、テキストと画像の融合、複雑なレイアウト、構造化されたビジュアル表現におけるV2の強みを継承しており、高密度の情報、複雑な版組、多様なビジュアルスタイルに対応可能です。
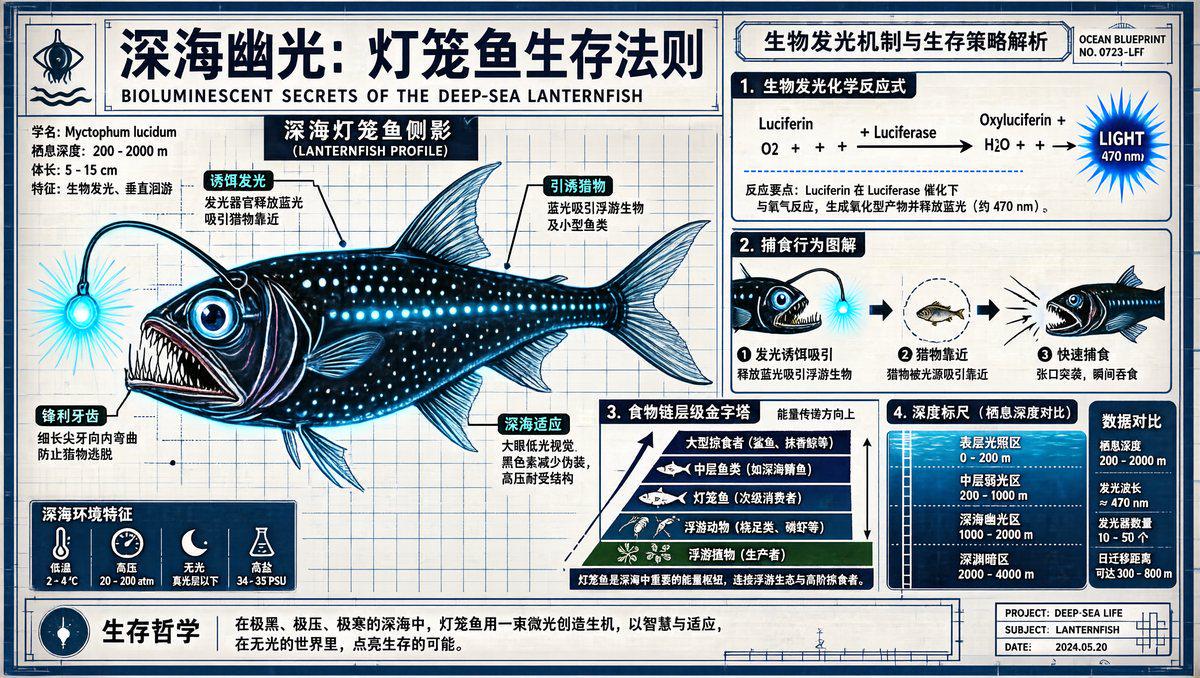
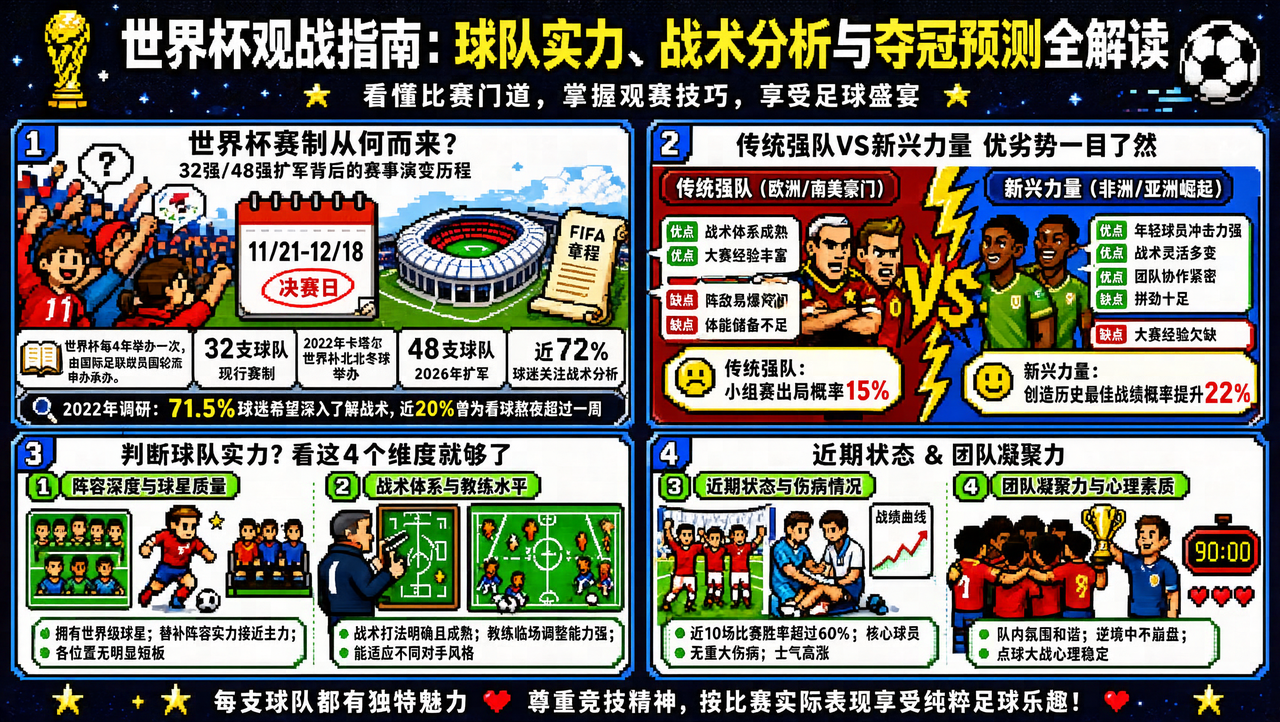
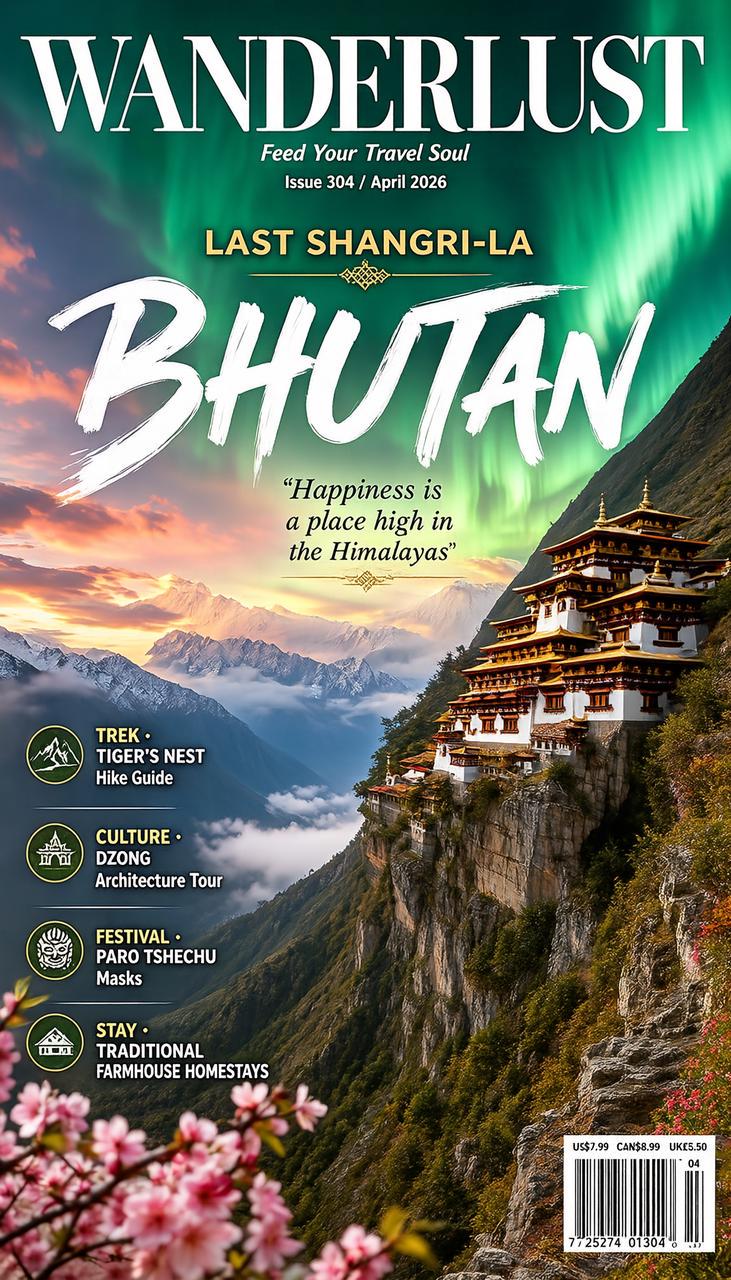
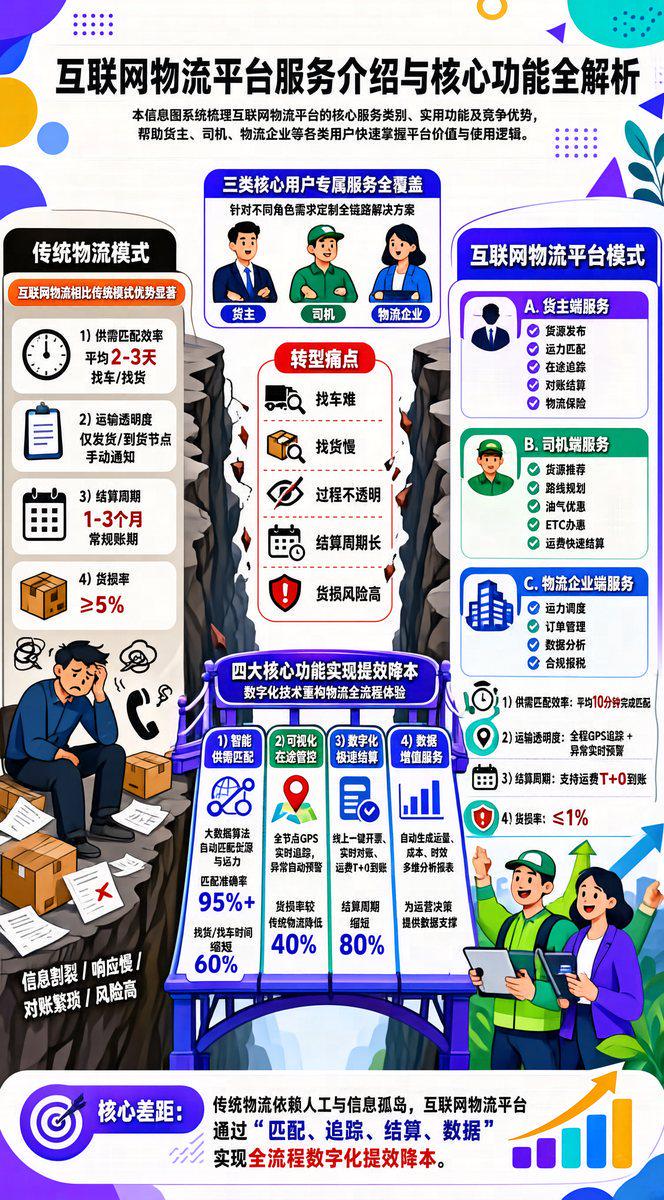
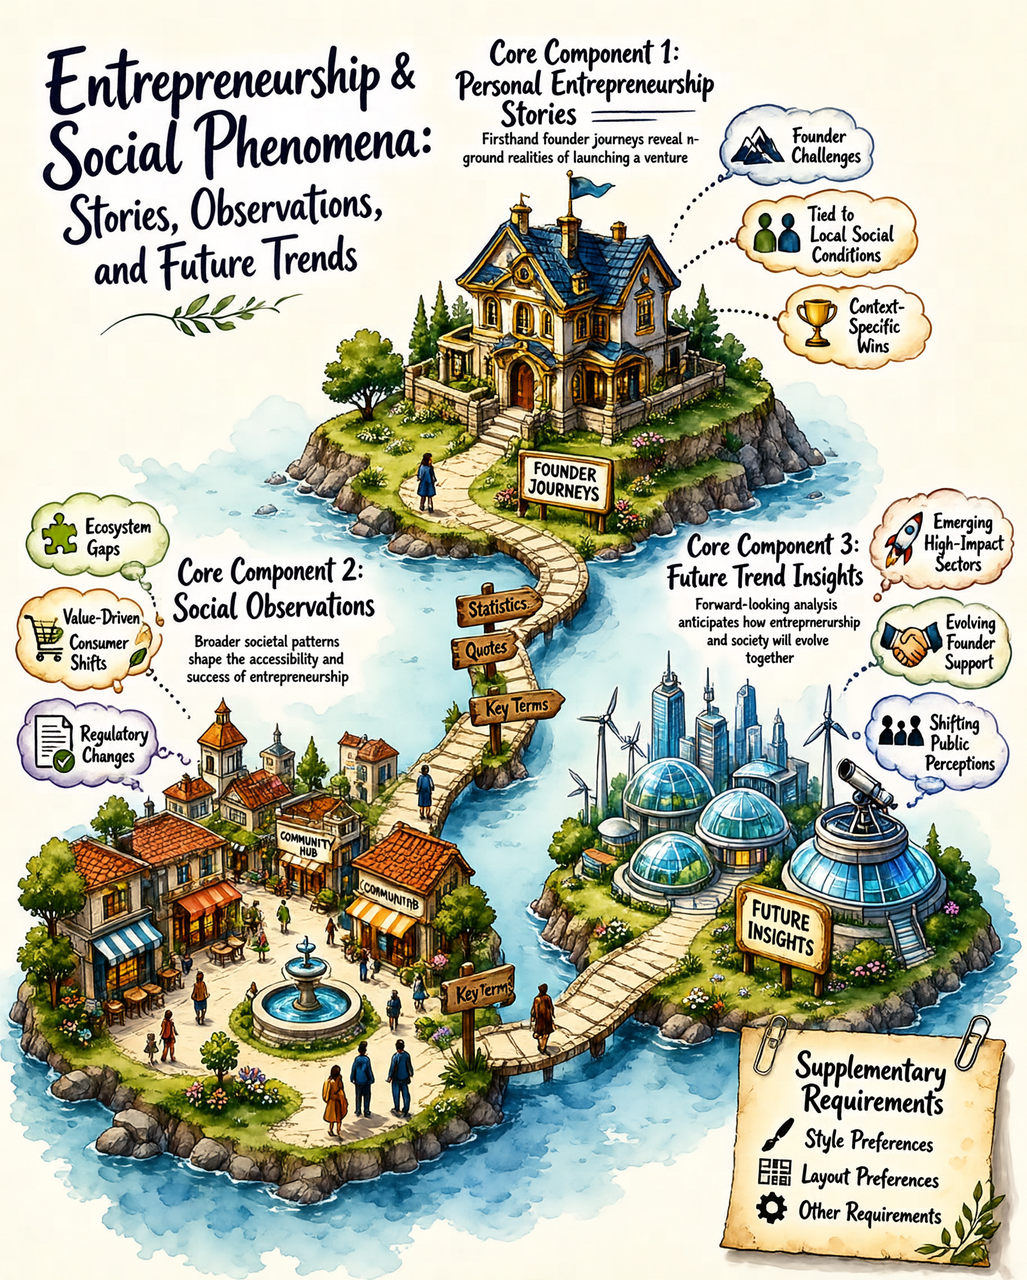
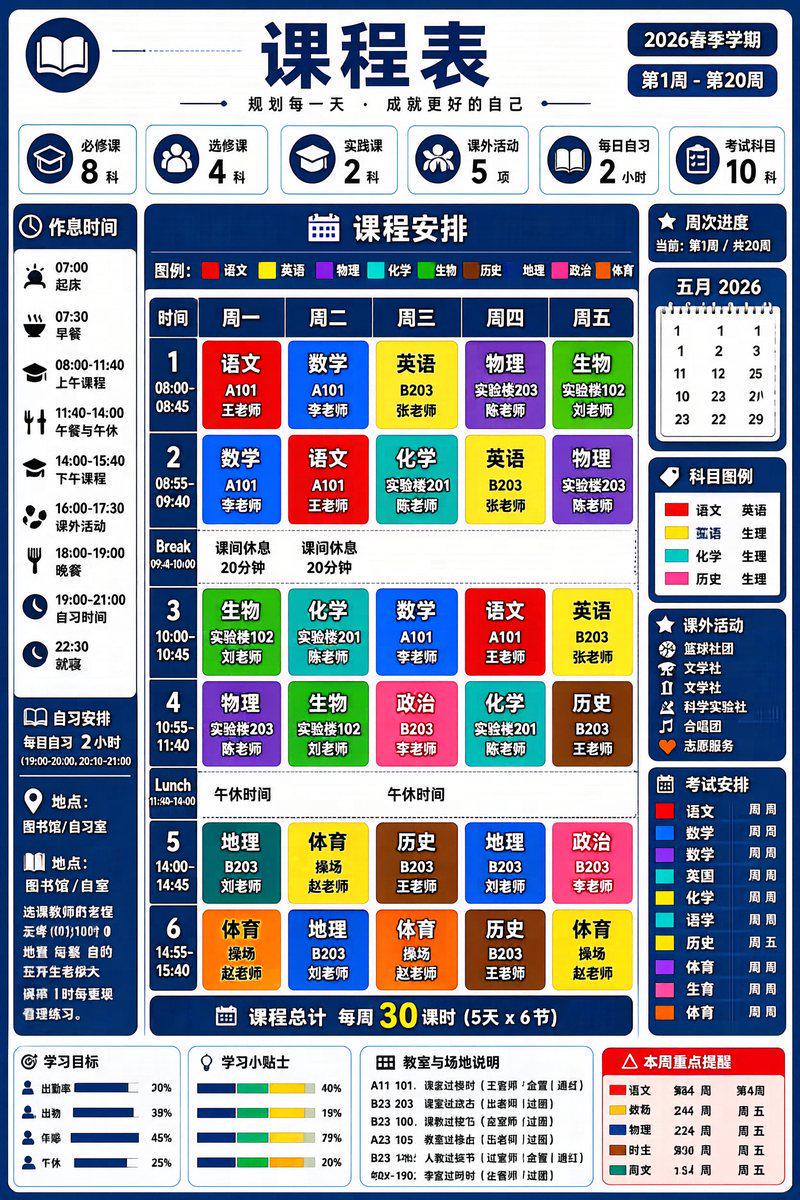
MT段階からの再学習により生成能力と編集能力を両立
安定したインフォグラフィック編集能力を獲得するため、事後学習(Post-training)での調整にとどまらず、MT(Mid-Training:中期学習)段階に遡って学習プロセスを再設計しました。実際の編集ニーズに基づき、多様な形式のインフォグラフィック編集データを合成し、テキストからの画像生成(T2I)と画像編集タスクを適正比率で共同学習させました。
モデルはMT、SFT(教師あり微調整)、RL(強化学習)の各段階を順次経ています。実験結果によると、この共同学習方式により、Infographic-V3は優れたインフォグラフィック生成能力を維持しながら、多様なテキスト編集およびスタイル編集能力を獲得しました。これにより、インフォグラフィックが「一発出力の結果物」から「継続的に修正可能なビジュアル作品」へと進化するための基盤が築かれました。
編集能力の新たな評価を実施:最近の2つのベンチマークで優れた結果を達成
新しく追加された編集能力に対し、テキスト編集能力に特化した評価ベンチマーク「WeEdit」を新設したほか、最近オープンソース化された「Qwen-Image-Bench」を導入してテキスト画像生成の総合能力を評価しました。評価結果から、Infographic-V3は両ベンチマークにおいて優れた性能を示し、テキスト修正、部分編集、総合画像編集の各能力が証明されたほか、テキスト画像生成の全体的な実力も着実に向上していることが確認されました。
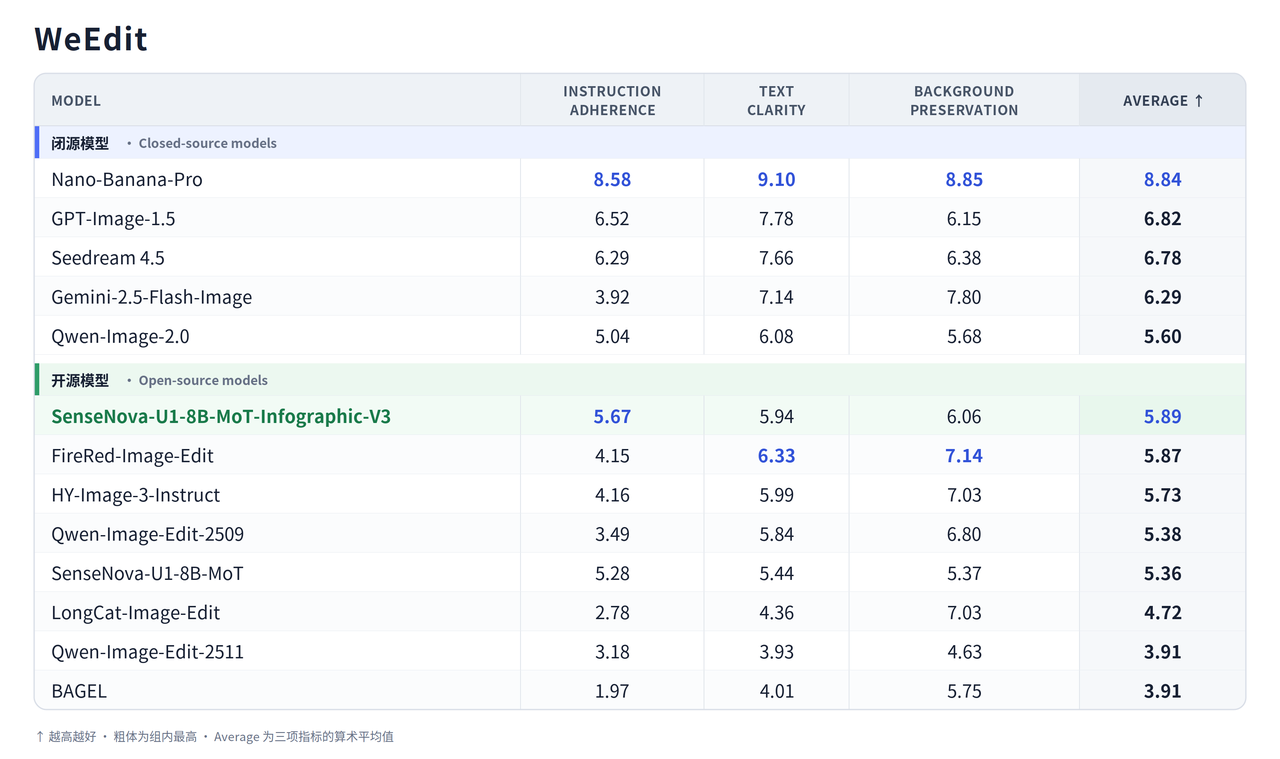
編集機能の評価ランキング「WeEdit」において、Infographic-V3は平均5.89点を記録し、オープンソースモデルの中で最高性能を達成しました。
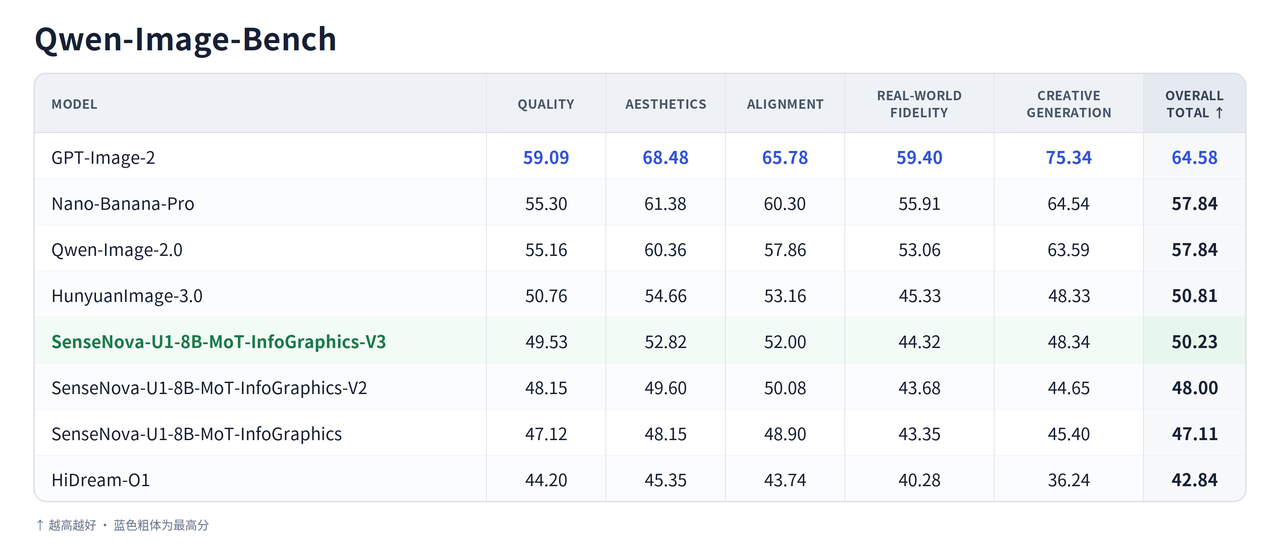
「Qwen-Image-Bench」においても、Infographicシリーズモデルの性能は着実に伸びています。
次のステップ:自己点検・自己修正・継続的イテレーションが可能なモデルへ
Infographic-V3はすでに1ターンの生成および修正能力を備えており、初回作成から追加入力による修正までシームレスな体験を実現していますが、これは始まりに過ぎません。SenseNova-U1アーキテクチャは画像とテキストを交互に思考する機能をネイティブでサポートしているため、将来的にはモデルがインフォグラフィックを生成した後に自らコンテンツやレイアウトをチェックし、問題を検知すると自律的に編集機能を呼び出して修正を行い、複数回のイテレーションを通じて成果物を最適化し続けることが期待されます。
「生成・検査・修正」のループが完成することで、インフォグラフィック制作は「ユーザーが何度もガチャを引く」作業から「モデルが自律的に完成品を磨き上げる」プロセスへと大きく進化します。当社は、1回で高品質なビジュアルコンテンツを提供するモデル能力を今後も強化し、AIインフォグラフィックをより信頼性が高く効率的な生産フローへと昇華させてまいります。
現在、「SenseNova U1 インフォグラフィック強化版V3」(SenseNova-U1-8B-MoT-Infographic-V3)は全世界のユーザーに向けてオープンソース公開されています。クリエイターや開発者の皆様のダウンロードと体験、ならびにフィードバックやご意見をお待ちしております。
モデルドキュメント:
[https://github.com/OpenSenseNova/SenseNova-U1/blob/main/docs/u1_infographic_model_CN.md](https://github.com/OpenSenseNova/SenseNova-U1/blob/main/docs/u1_infographic_model_CN.md)
ModelScope:
[https://modelscope.cn/models/SenseNova/SenseNova-U1-8B-MoT-Infographic-V3](https://modelscope.cn/models/SenseNova/SenseNova-U1-8B-MoT-Infographic-V3)