

 リターンマッチ
- ニュース
Vision Bananaを超える!SenseTimeがSenseNova-Visionをオープンソース化:ビジョンタスクを大統合、従来のビジョン技術を大規模モデルに統合
本日、私たちは「SenseNova-Vision」理解・生成統合ビジョン大規模モデルを正式に発表し、全面オープンソース化いたしました。これはSenseTimeの「SenseNova」大規模モデル体系における重要な視覚能力のアップグレードとなります。
業界でこれまで扱われてきた「統合ビジョン」の多くは、物体検出、領域分割、深度予測といった複数の専門モデルをパッケージ化してカプセル化したものに過ぎず、本質的には断片化されたままでした。
SenseNova-Visionの核心的な変革は、視覚を汎用基盤モデルのネイティブな能力とし、大規模モデル体系に完全に融合させた点にあります。これにより、目標検出、画像セグメンテーション、深度予測、3D復元などのすべてのクラシックなコンピュータビジョンタスクがネイティブに統一されました。
GitHub:
https://github.com/OpenSenseNova/SenseNova-Vision
この「ネイティブな融合」は双方向の相乗効果をもたらします:
データによる還元:視覚分野における数十年分の高品質データが、大規模モデル基盤の視覚理解能力を直接引き上げます。
思考能力の付与:大規模言語モデル(LLM)の推論能力が視覚タスクに適用され、言語によって新しい視覚タスクを直接定義することさえ可能になります。
視覚AI分野において、SenseTimeは10年連続で中国の視覚AI市場シェア第1位を獲得しており、2025年には動画分析セクターで世界市場シェア第1位およびアジア太平洋地域市場シェア第1位に初めて登り詰めました。SenseNova-Visionは、この業界をリードする視覚能力を統一マルチモーダル大規模モデル体系に融合させており、視覚AI能力の飛躍的な進化を象徴しています。ネイティブ統一という技術路線により、モデルは「実行ツール」から「世界理解モデル」へと本質的な変貌を遂げました。物理世界のロジックを真に理解するだけでなく、物理世界におけるAIの幅広い応用と深いインタラクションのための全く新しい汎用基盤を構築します。
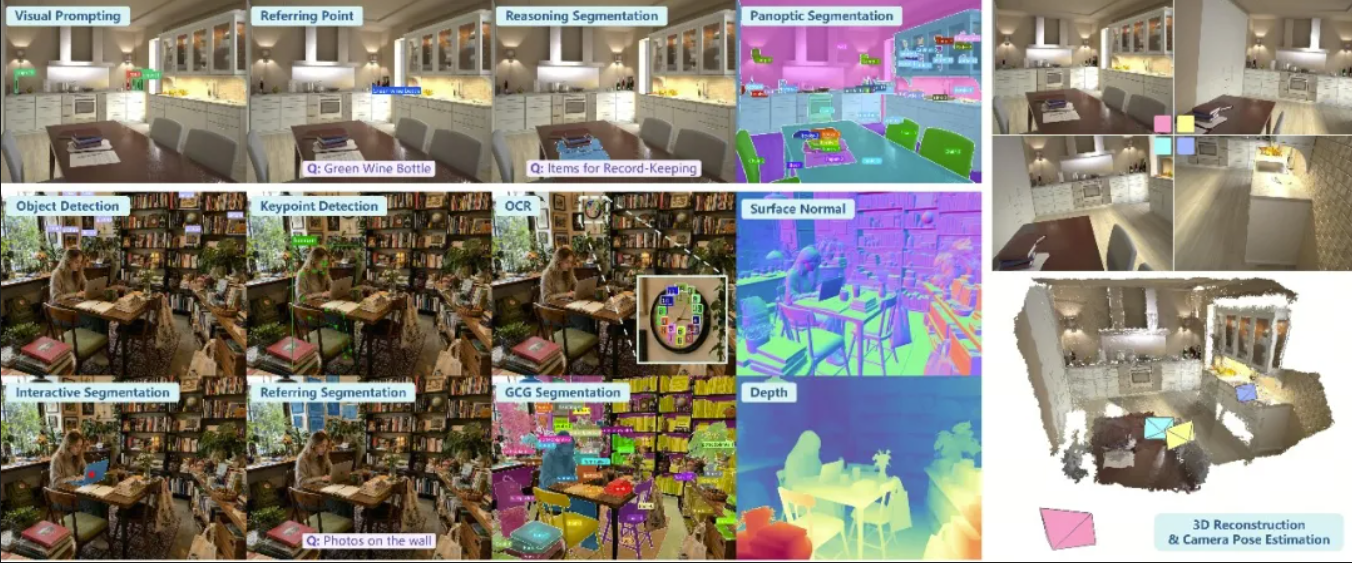
SenseTimeの「SenseNova-Vision」は、構造化視覚理解、高密度幾何予測、画像セグメンテーション、マルチビュー視覚ジオメトリなど、多くの核心的タスク能力をネイティブかつ統一的に実現できます
複雑なシーンでの実測:自由な指示の下での「視覚のマインドリーディング」
従来の視覚モデルは「それぞれの役割を果たす」にとどまり、複雑で妨害のあるシーンに遭遇すると「手上げ」状態になることがよくありました。ネイティブ汎用基盤がもたらす知能の創発(Emergence)のおかげで、SenseNova-Visionは人間の視覚でさえ間違いやすい極端なシーンに対しても、驚異的な汎化能力を発揮します:
1、ゼロショット汎化:未知のゲームを「一瞬で理解」
訓練データに含まれていないゲーム画面に対して、モデルは強力なドメイン超越適応力を示します。言語推論とネイティブ視覚能力の融合により、事前の再学習なしで、画面内の表面法線、インスタンスセグメンテーション、キャラクターのキーポイント検出を同時にシームレスかつ精細に処理できます。映像、ゲーム、デジタルコンテンツのクリエイターは、これを直接ワークフローに投入可能です。
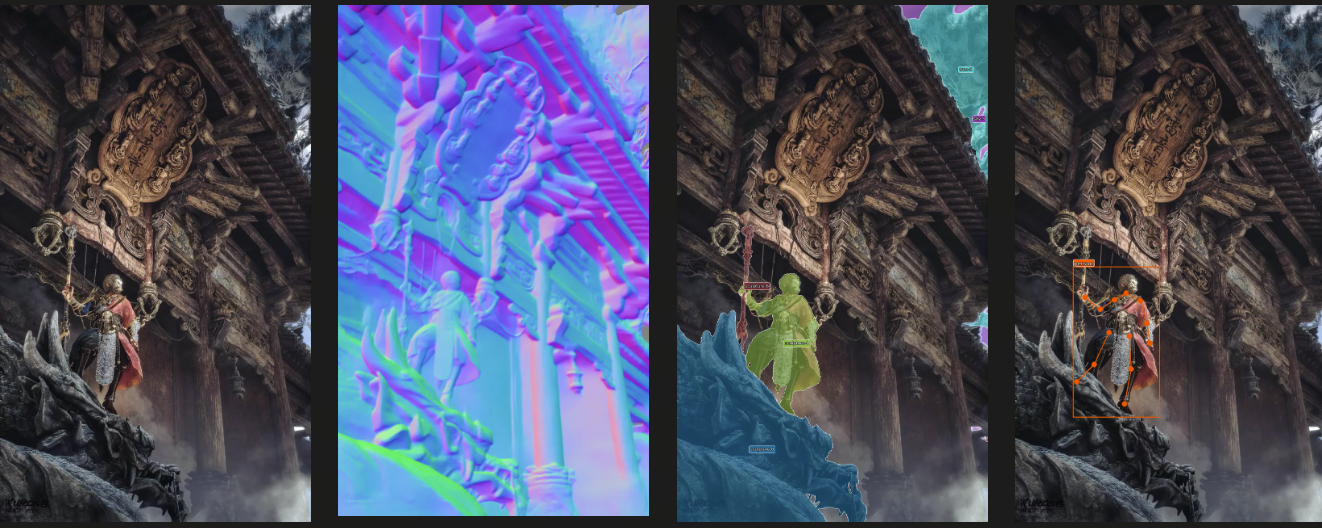
ゲーム『黒神話:悟空』のシーン画像を一例とすると、モデルは法線、セグメンテーション、キーポイントなどを非常に良好に処理できます
2、超高密度物体のセグメンテーション:重なり合う魚群も個々に認識
密集して大きく重なり合った魚群や羊の群れ、あるいは商品の棚、上空から撮影された車両などの極めて高密度なシーンにおいて、モデルは外科手術のように精確に各個体を分離できます。色が非常に近く、境界や深度が複雑に交錯していても正確に区別可能です。これは産業用カウントやスマート物流倉庫などのシーンにまったく新しい解法を提供します。
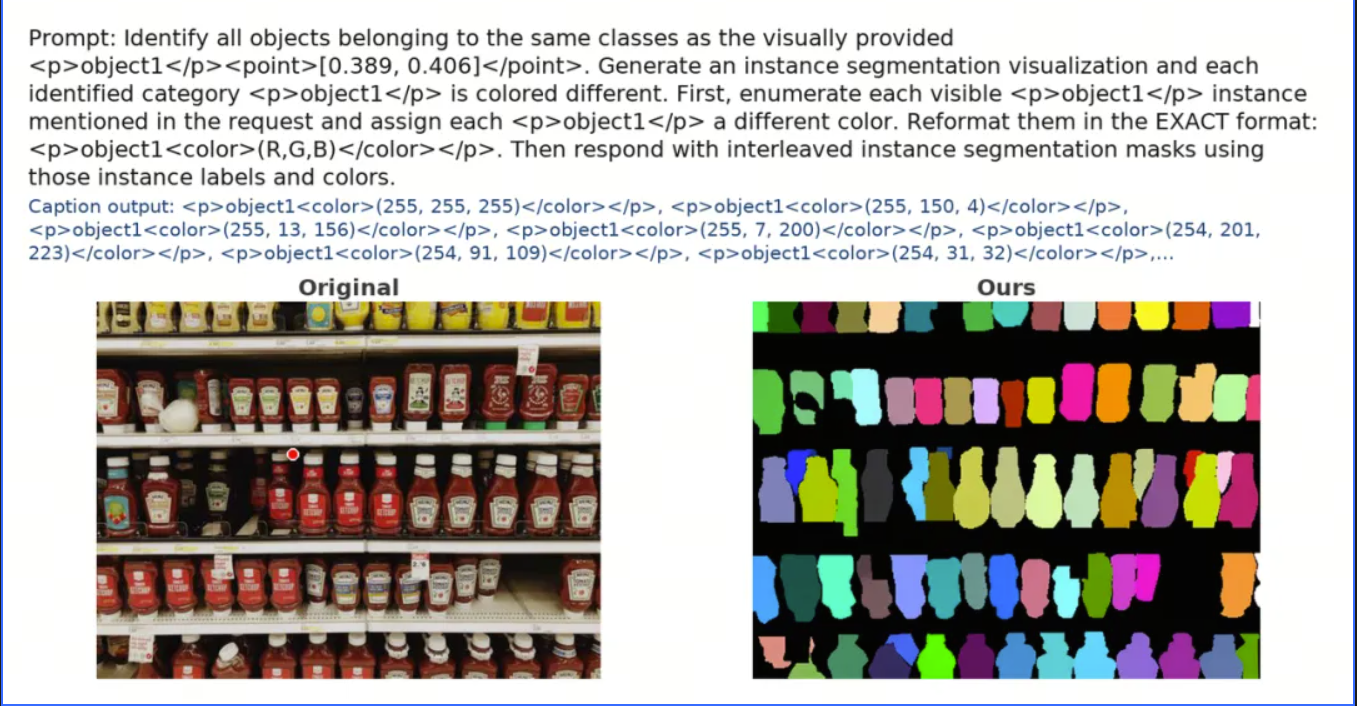
色が重なり合う魚群や、棚に倒れかけた商品を一例とすると、モデルは鮮明かつ正確なセグメンテーションを実行できます
3、鏡面反射の見破り:空間ジオメトリを正しく復元
鏡やガラスが含まれる複雑な室内環境において、従来の視覚モデルは鏡内の反射映像に容易に誤導されていました。SenseNova-Visionは反射映像の錯覚を自動的に除去し、鏡の中の物体の真の空間方向と深度関係を正確に推定します。虚構の反射に惑わされることなく、三次元空間ジオメトリの本質に対する深い理解を示します。
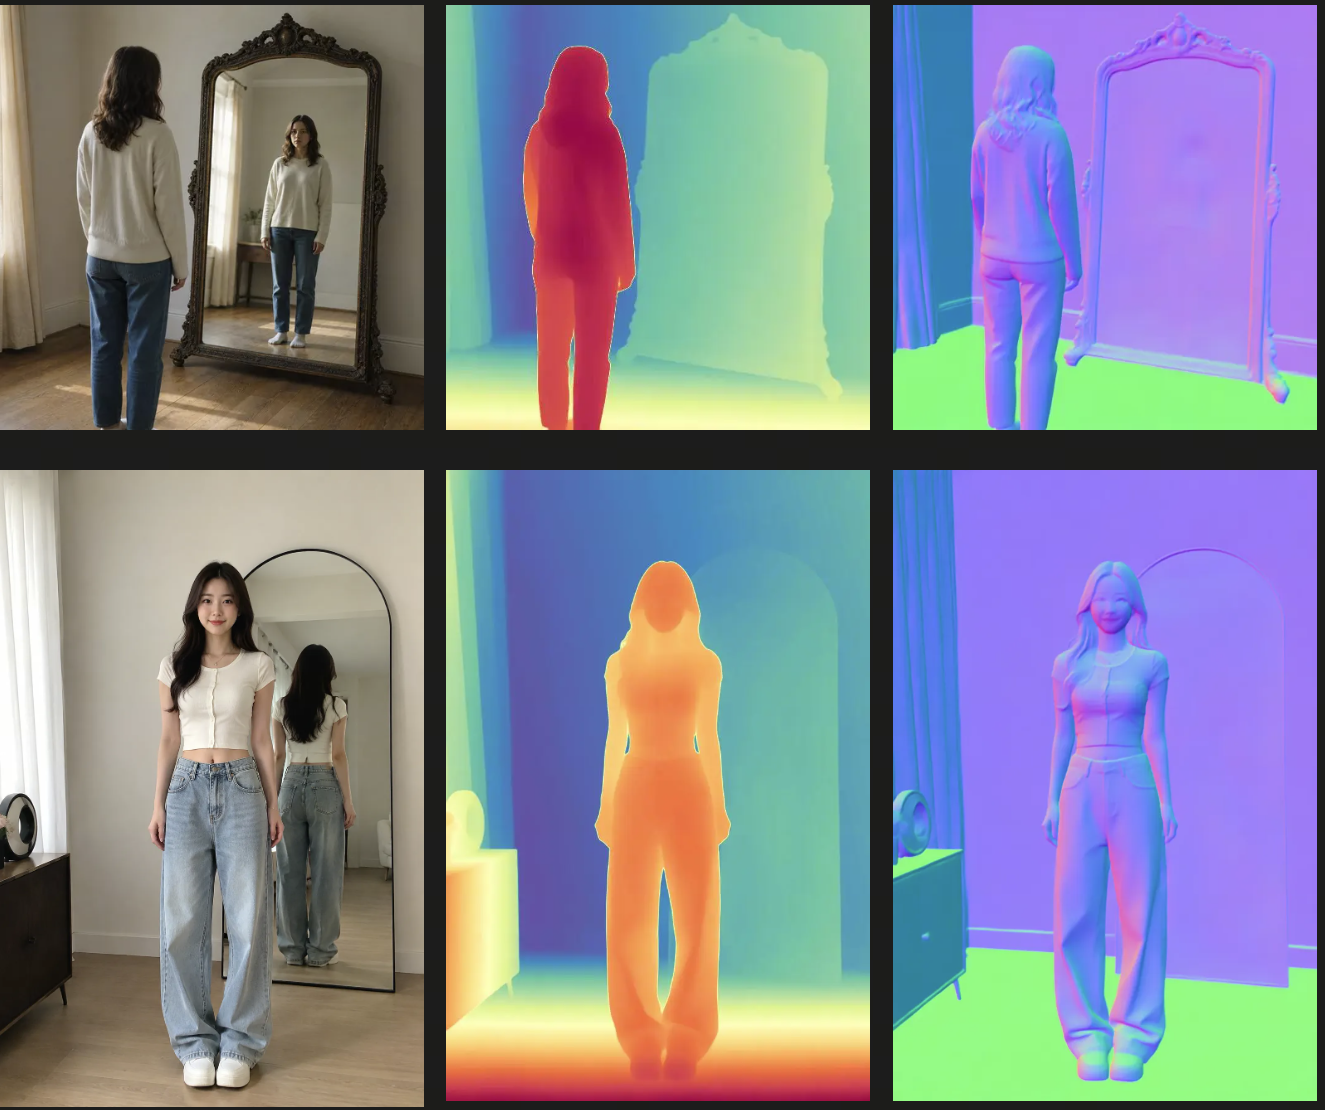
鏡面の一例として、モデルは鏡の中の人物の方向と深度を正確に推定できます
4、視覚的錯覚の突破:表面にとらわれず、空間の本質を見抜く
視覚的錯覚の妨害が満載された画像(遠近法を利用したトリック写真など)において、モデルは遮蔽された物体の完全な輪郭を正確に切り抜くだけでなく、完全に正しい表面法線推定を出力します。パターンやトリックに騙されないこの能力は、言語モデルの推論能力と高密度幾何予測が完璧に融合し、物理世界を正しく理解していることの具現化です。
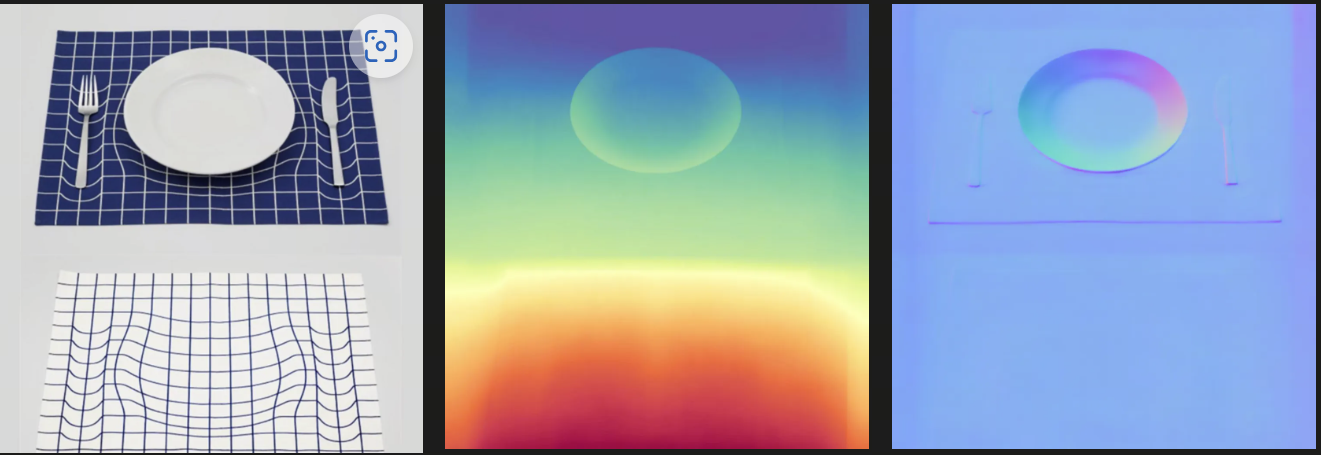
モデルはテクスチャによる視覚的欺瞞を正しく判断できます
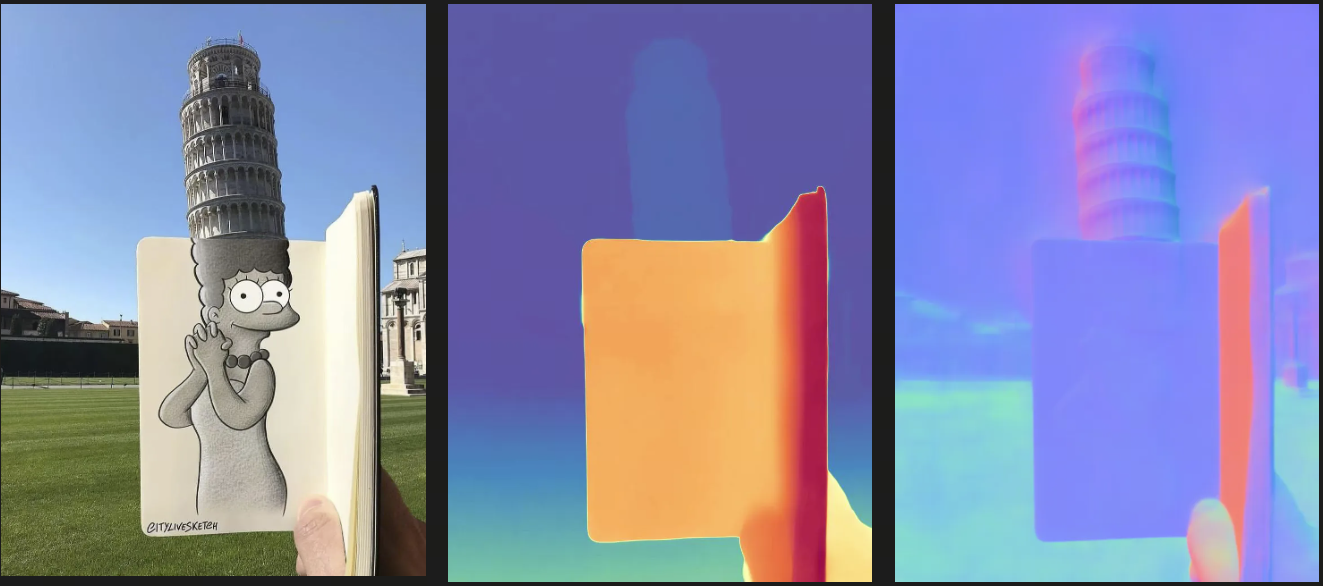 モデルは遠近法による大小現象を完璧に把握しており、まったく誤導されません
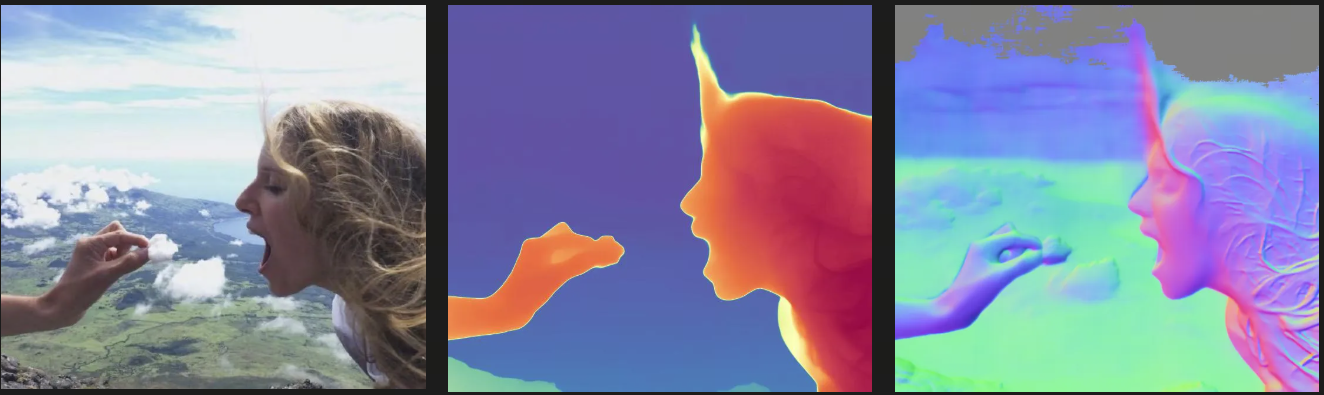 前景の綿の人物と背景の雲を成功裏に分離
核心タスクで牽引:数々の指標で専用専門モデルと肩を並べる
視覚タスクが汎用マルチモーダル生成に融合されたことで、専門能力が弱まるどころか、クロス算術ナレッジの相乗効果によりパフォーマンスが飛躍的に向上しました。多くの権威あるベンチマークにおいて、SenseNova-Visionは「単一モデル」でありながら4つの核心的視覚領域で広範囲にリードし、各分野の専用「専門モデル」と同等以上、あるいはそれを超える成果を達成しました:
構造化視覚理解:目標検出、参照表現理解(Referring)、OCR、キーポイント測位などのタスクにおいて、同タイプの汎用モデルを全面的にリード。高密度な小目標検出やロングテールカテゴリ認識などの複雑なシーンで特に顕著な成果を示します。
高密度幾何予測:深度推定、表面法線(Surface Normal)推定精度が幾何専用モデルの水準に達し、屋内外の多様なシーンで極めて高い安定性を維持します。
セグメンテーション能力:汎用セグメンテーション、推論セグメンテーション、対話型セグメンテーションなどを網羅。強力なマルチモーダル理解力により、推論セグメンテーション(Reasoning Segmentation)や対話型セグメンテーション(GCG Segmentation)において優れたパフォーマンスを発揮します。
マルチビュー3Dジオメトリ:単一モデルのみで、高精度なマルチビュー点群再構成およびカメラポーズ推定を完了でき、汎用視覚路線においてトップクラスの位置を占めています。
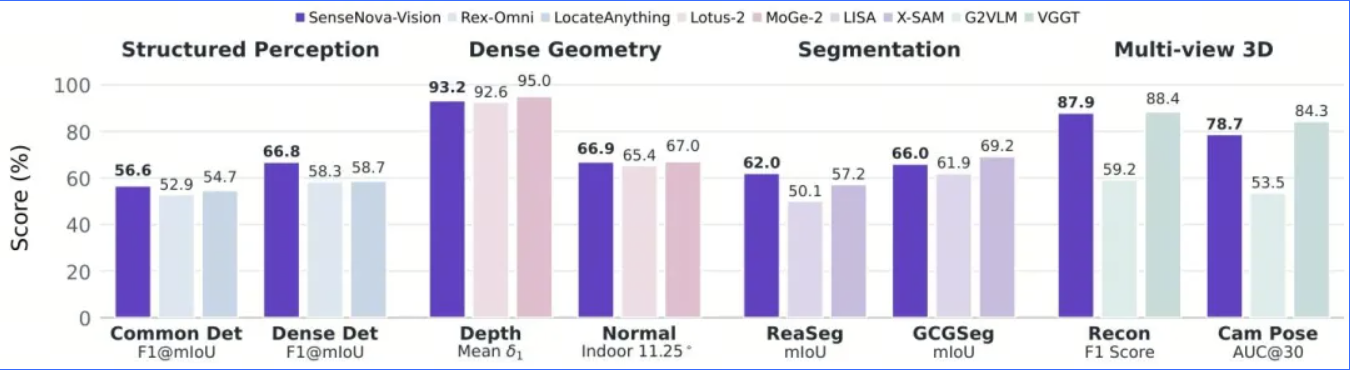
核心指標の評価:SenseNova-Vision(濃い紫色のバー)は、各視覚タスクにおいて首位の位置を占めています
横向比較の優位性:
セマンティクス指向モデルとの比較(Youtu-VLなど):SenseNova-Visionは、詳細な表現が極めて強く求められる検出、セグメンテーション、深度などの視覚タスクにおいて全面的なリードを実現。
生成指向モデルとの比較(Vision Bananaなど):世代を超えた圧倒的な優位性を示しています。
a. 核心指標での凌駕:各権威的評価の直接対決において、SenseNova-Visionは大半の指標でVision Bananaを凌駕しリード。
b. タスク能力の倍増と全面的なオープンソース化:より強力なマルチタスク汎化能力を実証。Vision Bananaが4つの核心セクションのうち「2種類」の問題にしか対応できないのに対し、SenseNova-Visionは構造化理解、高密度幾何、全景セグメンテーション、マルチビュー3Dなどの全タスクを一網打尽にします。さらに、SenseNova-Visionはモデルとデータの両方を全面的にオープンソース化しています。
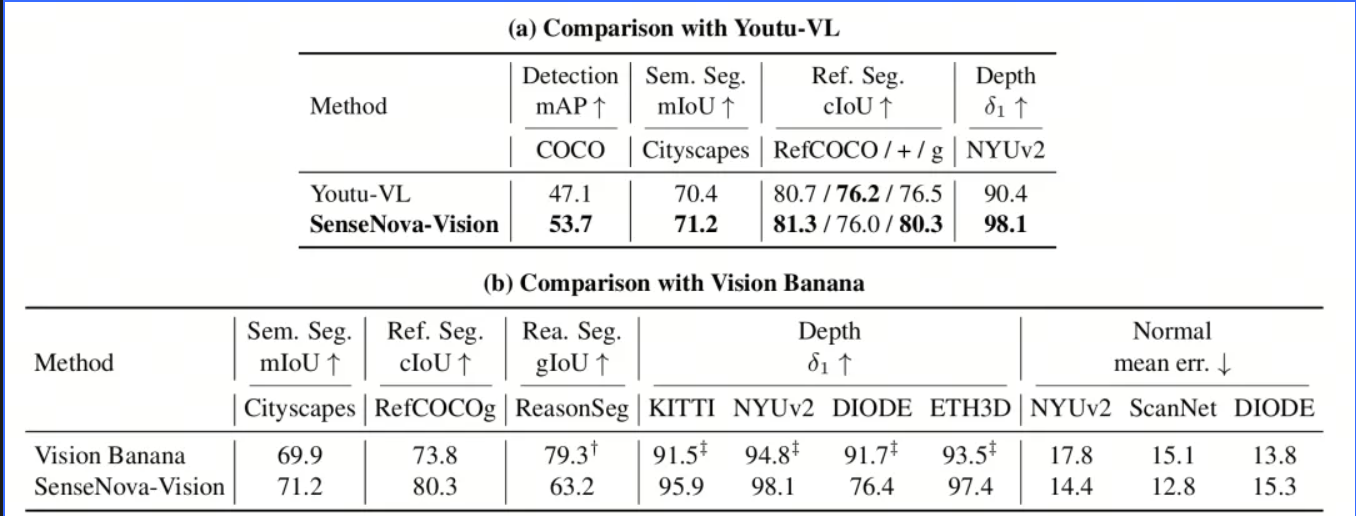
アーキテクチャの根本的ロジックを再構築:「継ぎはぎ」から「ネイティブな統一」へ
長年にわたり、視覚AIは「1つのタスクに1つのモデル」という経路で進化してきましたが、各タスクは互いに孤立した島となっていました。
SenseNova-Visionはこの構造的ボトルネックを完全に打破し、すべての視覚タスクを汎用基盤モデルが理解可能なマルチモーダル生成問題として初めて統一的に表現しました。タスクごとに専用の予測ヘッドを設計する必要はなく、テキスト、ピクセル、セマンティック情報、幾何学的特徴を同じ共有表現空間内で直接一元的にモデリングします。
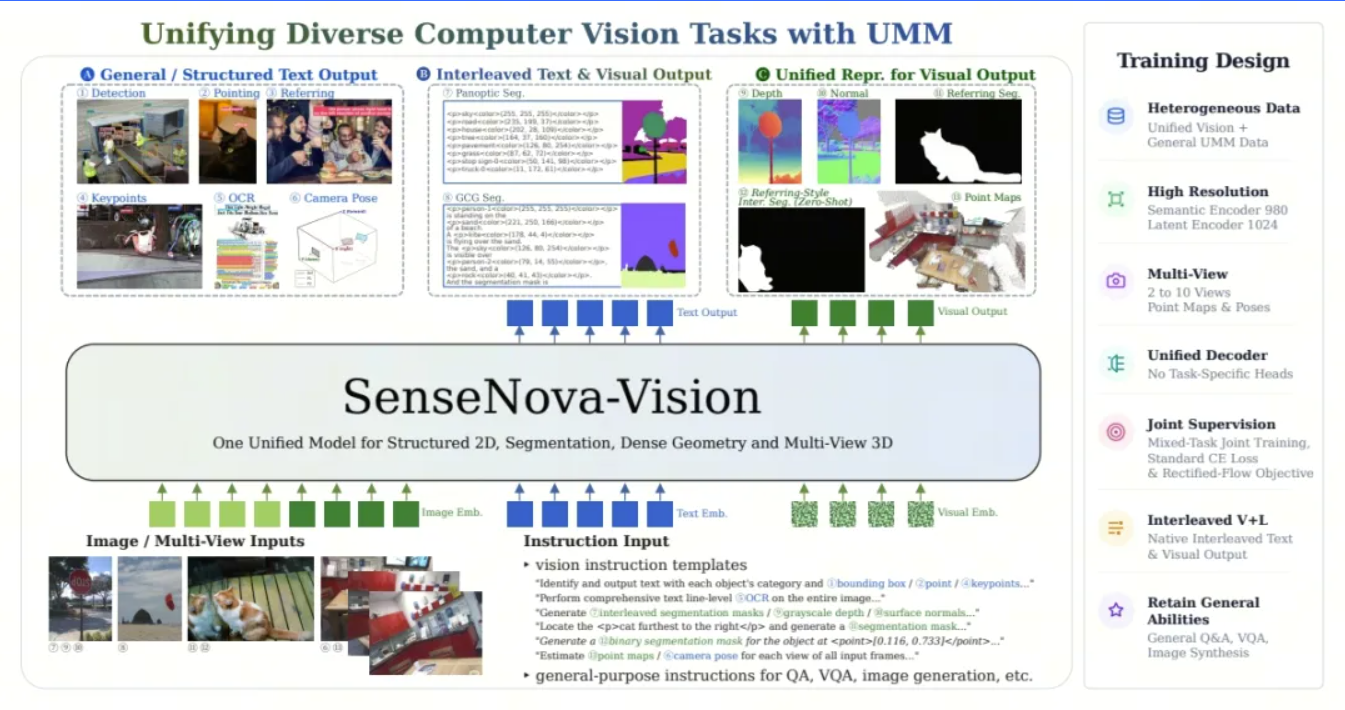
この「大統一」設計は、革新的な変化をもたらしました:
タスク間のナレッジ相乗効果による1+1>2の実現:モデルの共同訓練により、異なるタスク間の内在的な補完性が活性化されます。深度推定のナレッジがセマンティックセグメンテーションの空間理解を強化し、セグメンテーション能力が検出タスクの境界判断を補助することで、単一タスクモデルでは到達できない抽象的推論能力を獲得し、未見のタスクやシーンにも柔軟に対応できます。
「ツール実行者」から「汎用理解者」への進化:統一パラダイムが視覚知能のあり方を再定義しました。モデルは特定指示を実行するだけのツールではなく、大規模モデルのネイティブな能力として、視覚世界に対する汎用で深い認知を持つマルチモーダル基盤へと成長しました。
SenseTimeのSenseNova-Visionの発表とオープンソース化は、「統一マルチモーダル生成」という新しい技術路線の絶大なポテンシャルを証明しました。これにより視覚AIの応用ハードルが大幅に下がり、開発者はタスクごとに複数のモデル体系を保守する必要がなくなります。単一モデルで高頻度の視覚ニーズをカバーできるため、研究開発期間の短縮とデプロイコストの削減を実現し、特に複雑な画像やオープンシーンにおける視覚アプリケーション開発に最適です。
同時に、SenseTimeは5,000万件の高品質サンプルを含む視覚指示コーパス「SenseNova-Vision Corpus-50M」を公開し、グローバルなAIエコシステムに強力な動力を注入します。
今後、SenseTimeはSenseNova-Visionのコア技術を「SenseNova Uシリーズ」大規模モデルに全面的に統合し、より強力な統一マルチモーダル基盤モデルの構築を継続的に探求していきます。物理世界をより深く知覚・推論・相互作用できる汎用人工知能(AGI)とワールドモデルを目指します。
モデルオープンソースアドレス:
Hugging Face:
https://huggingface.co/collections/sensenova/sensenova-vision
GitHub:
https://github.com/OpenSenseNova/SenseNova-Vision
ModelScope:
https://modelscope.cn/models/SenseNova/SenseNova-Vision-7B-MoT